
Tabla de contenido
- ¿Qué es la repatriación en la nube?
- Tendencias de repatriación a la nube: por qué las empresas trasladan cargas de trabajo de vuelta a la nube.
- Repatriación total frente a repatriación parcial: ¿qué cargas de trabajo son buenas candidatas?
- Coste de la nube frente al de las instalaciones locales: cómo comparar el TCO (coste total de propiedad).
- Estrategia de salida de la nube paso a paso
- Riesgos de la migración inversa a la nube y cómo reducirlos
- Ejemplos reportados públicamente: 37signals, Dropbox y GEICO.
- Cómo la plataforma Hystax admite la repatriación a la nube
Conclusiones clave
- Las cargas de trabajo constantes suelen ser más económicas en infraestructura propia. Las cargas de trabajo con picos repentinos generalmente son más económicas en la nube pública.
- Los descuentos por optimización del tamaño de la infraestructura y por compromiso pueden reducir tanto la diferencia entre los costes de la nube pública y la infraestructura propia que la migración deja de ser rentable.
- Los proveedores de servicios en la nube eximen a los clientes que se dan de baja de las tarifas de cancelación, y la Ley de Protección de Datos de la UE prohíbe los cargos por cambio de proveedor a partir de enero de 2027.
- Tras la repatriación, la nube pública puede seguir utilizándose como sitio de recuperación ante desastres.
La repatriación a la nube consiste en trasladar aplicaciones, datos o máquinas virtuales desde una nube pública a la infraestructura que controla la empresa. Esta puede ser una nube privada, un centro de datos local o un centro de coubicación. La mayoría de los proyectos abarcan cargas de trabajo específicas; la repatriación completa es poco frecuente.
¿Qué es la repatriación en la nube?
Durante años, “la nube primero” fue la estrategia predeterminada, y muchos equipos migraron tanto como pudieron. La mayoría de las empresas ahora manejan una combinación de entornos: según Informe sobre el estado de la nube de Flexera para 2026, El 731% de las organizaciones utiliza una nube híbrida. En una configuración híbrida, la repatriación a la nube forma parte de la ubicación de las cargas de trabajo. Los términos que se mencionan a continuación suelen confundirse, por lo que aquí se explican sus diferencias.| Término | Qué significa | Alcance típico |
|---|---|---|
| repatriación de la nube | Migración de cargas de trabajo o datos desde la nube pública a infraestructura privada, local o de coubicación. | Una aplicación, una capa de datos o un grupo de máquinas virtuales. |
| Migración inversa a la nube | Otro nombre para la repatriación que pone énfasis en la dirección del traslado. | Igual que la repatriación |
| Salida de la nube | Abandonar por completo un proveedor de nube pública, para operar en las instalaciones o en otra nube. | Todas las cargas de trabajo y los datos |
| Asignación de carga de trabajo | La práctica continua de decidir dónde debe ejecutarse cada carga de trabajo. | Toda la cartera |
Tendencias de repatriación a la nube: por qué las empresas trasladan cargas de trabajo de vuelta a la nube.
Costo de las cargas de trabajo constantes
El modelo de pago por uso se adapta bien a la demanda variable. Una carga de trabajo que se ejecuta al mismo nivel las 24 horas del día es otra historia, y a lo largo de los años puede resultar más cara en la nube que en hardware propio. El modelo de precios bajo demanda permite aumentar o disminuir la capacidad en cualquier momento, y una carga de trabajo que nunca se escala sigue pagando por esa opción sin usarla.
Tarifas de salida
Cargas de trabajo de IA y GPU
Seguridad y soberanía de los datos
Las preocupaciones sobre las filtraciones de datos y el cumplimiento normativo también retrasan algunas cargas de trabajo. Las empresas de sectores regulados, como las finanzas y la sanidad, necesitan saber dónde se encuentran sus datos y quién puede acceder a ellos. Para algunas, eso significa trasladar sistemas sensibles a una nube privada. Otras se trasladan a una nube soberana como PILAR, que almacena los datos en centros de datos de la UE.
Reserva una demostración para ver cómo trasladar tus máquinas virtuales de AWS, Azure o Google Cloud a una nube privada.
¡Gracias por tu solicitud!
Nos pondremos en contacto contigo pronto.
Repatriación total frente a repatriación parcial: ¿qué cargas de trabajo son buenas candidatas?
La repatriación total es ideal para empresas con una demanda estable, una factura de servicios en la nube elevada que apenas varía mensualmente y un equipo de operaciones propio. La mayoría opta por la repatriación parcial, trasladando las cargas de trabajo donde la infraestructura propia ofrece una clara ventaja y dejando el resto en la nube.
| Buenos candidatos para la repatriación | Mejor mantenerlo en la nube pública. |
|---|---|
| Cargas de trabajo de producción con una carga plana 24/7: pagan precios bajo demanda por la capacidad que siempre utilizan. | Cargas de trabajo estacionales: el hardware propio permanecería inactivo entre los picos de actividad. |
| Grandes bases de datos y niveles de almacenamiento con alto volumen de salida: cada transferencia saliente aumenta la factura. | Entornos de desarrollo y pruebas de concepto efímeros: terminan antes de que los servidores comprados resulten rentables. |
| Inferencia de IA en producción con uso constante de GPU: las GPU están ocupadas todo el tiempo. | Experimentos que requieren las GPU más recientes durante algunas semanas: comprar ese hardware para una prueba corta rara vez vale la pena. |
| Sistemas con estrictas normas de residencia o auditoría de datos: la infraestructura propia facilita la demostración de la ubicación de los datos. | Aplicaciones basadas en servicios gestionados y específicos del proveedor: cada servicio tendría que ser reemplazado o reconstruido. |
| Las máquinas virtuales heredadas se trasladaron sin cambios: no utilizan servicios nativos de la nube, por lo que se migraron sin necesidad de rehacer el trabajo. | Servicios globales que requieren muchas regiones: igualar esa presencia implica operar muchos centros de datos. |
Las cargas de trabajo inactivas o sobredimensionadas son un caso aparte. El informe de Flexera de 2026 sitúa el gasto desperdiciado en la nube en 291 TP3T, su primer aumento en cinco años. Ese desperdicio es un gestión de costes El problema surge al trasladar las cargas de trabajo a hardware propio, lo que permite mantenerlo en su lugar.
Coste de la nube frente al de las instalaciones locales: cómo comparar el TCO (coste total de propiedad).
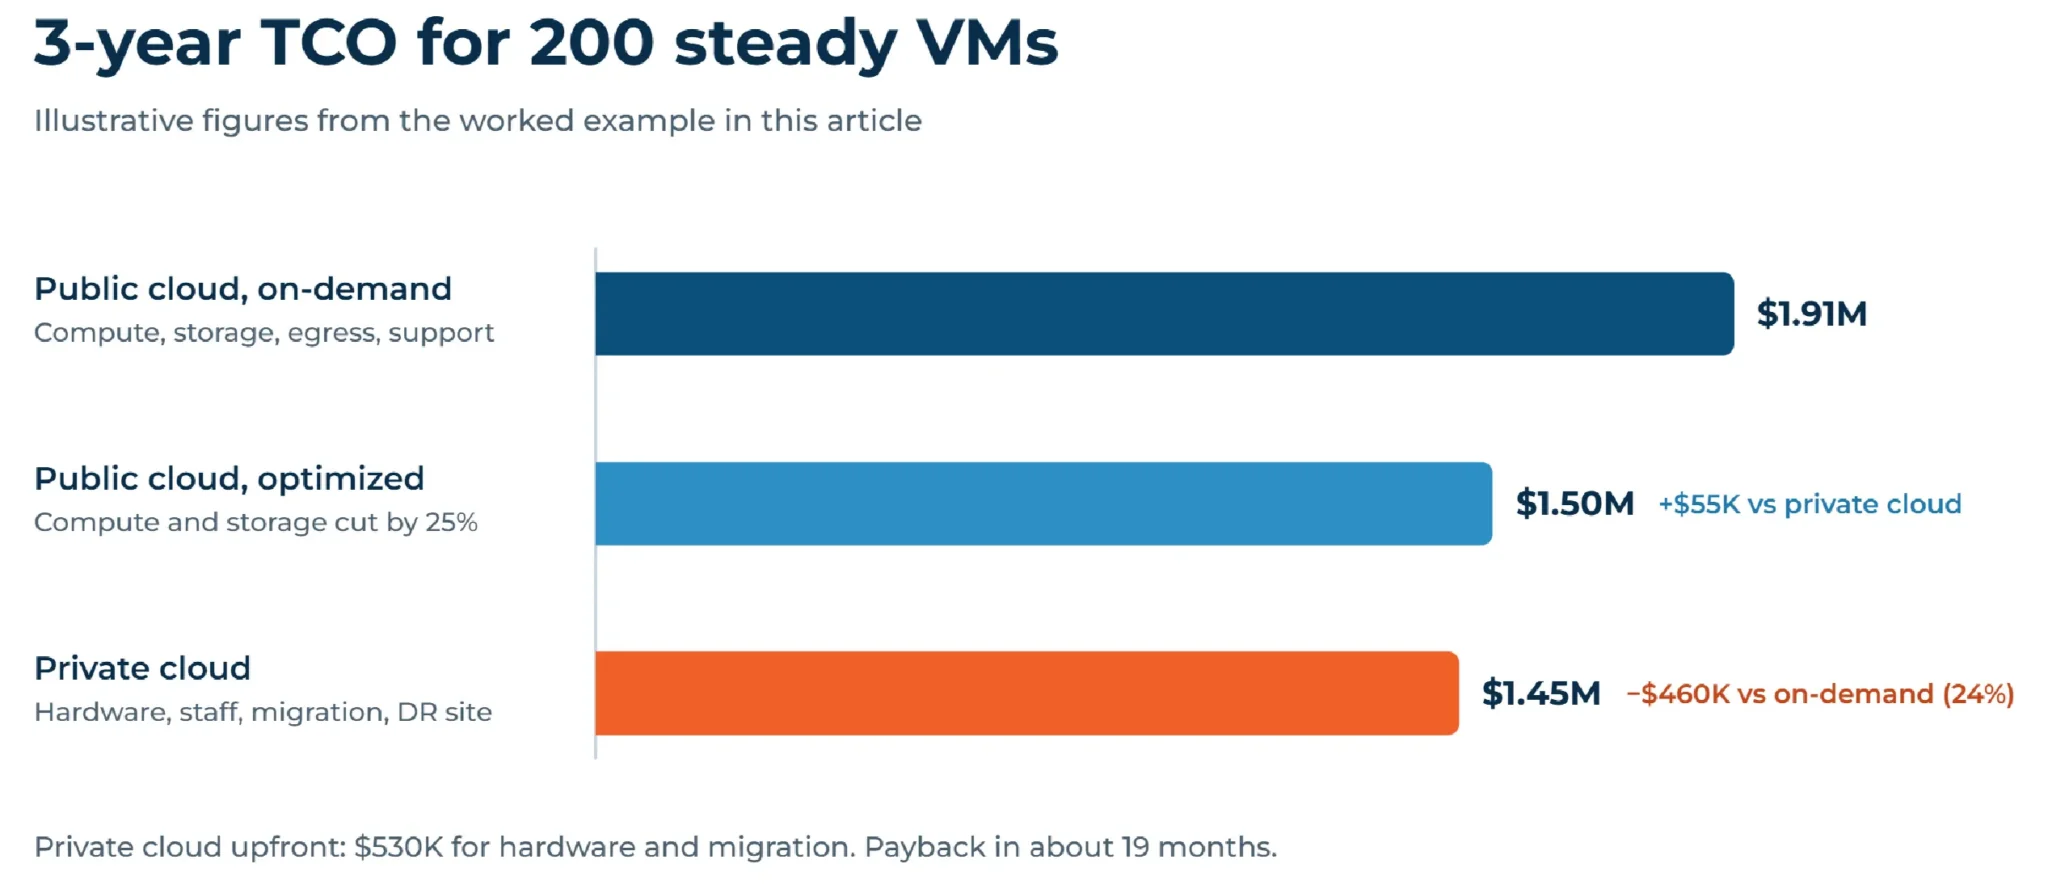
Comparar los costos de la nube frente a las soluciones locales es más difícil de lo que parece. En la encuesta de Flexera de 2026, el 431% de los encuestados la mencionó como un desafío para la migración a la nube, ubicándola en tercer lugar. Una comparación justa utiliza el mismo horizonte temporal en ambos casos (generalmente de tres a cinco años) y el mismo nivel de servicio.
Esta fórmula se aplica tanto a la nube pública como a la privada:
Costo total de propiedad = costos iniciales + costos operativos mensuales × número de meses
En la nube pública, casi todo representa un costo operativo: computación, almacenamiento, transferencia de datos, soporte y servicios gestionados. Una nube privada concentra gran parte del gasto inicial en hardware y el proyecto de migración. Además, implica costos operativos adicionales por espacio en el centro de datos, licencias, personal de operaciones y un sitio de respaldo o recuperación ante desastres.
Ejemplo resuelto
Las cifras que se muestran a continuación son ilustrativas. El ejemplo supone una producción constante de 200 máquinas virtuales durante tres años.
| Línea de costos | Nube pública, 3 años | Nube privada, 3 años |
|---|---|---|
| Computación y almacenamiento | $1.620.000 ($45.000/mes) | $450.000 (hardware) |
| Salida | $108.000 ($3.000/mes) | — |
| Centro de datos, energía y red | — | $216.000 ($6.000/mes) |
| Soporte, licencias y servicios gestionados | $180.000 ($5.000/mes) | $180.000 ($5.000/mes) |
| Proyecto de migración único | — | $80,000 |
| Sitio de recuperación ante desastres y de respaldo (almacenado en la nube pública) | — | $72.000 ($2.000/mes) |
| Total | $1,908,000 | $1,448,000 |
En este escenario, la nube privada ahorra $460 000 en tres años, o aproximadamente 24%. Con una inversión inicial de $530 000 en hardware y migración, la recuperación de la inversión se produce después de aproximadamente 19 meses. Las cifras de la nube pública asumen que la línea de computación y almacenamiento incluye copias de seguridad y redundancia multizona.
La optimización de la nube cambia el panorama. Si los descuentos por compromiso y la optimización del tamaño reducen la demanda de computación y almacenamiento en la nube en una cuarta parte, la diferencia se reduce a aproximadamente $55,000, demasiado pequeña como para justificar una medida basada únicamente en el costo.
Estrategia de salida de la nube paso a paso
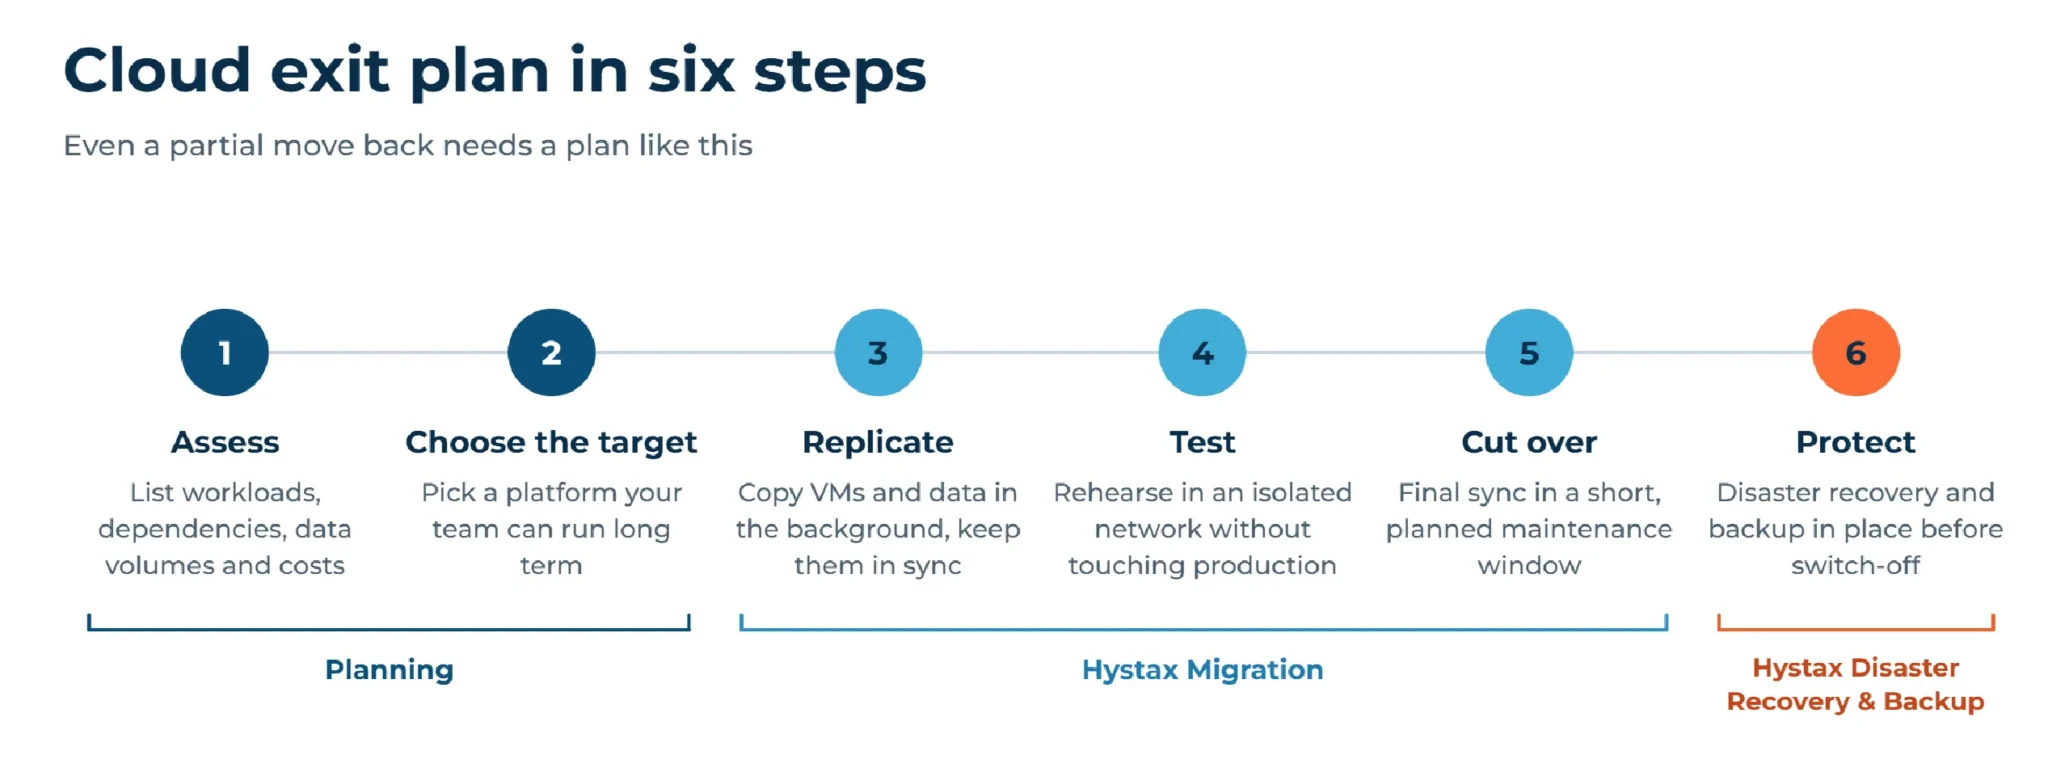
Incluso una migración parcial requiere un plan que funcione como una estrategia de salida de la nube. Sigue la lógica de cualquier proyecto de migración, pero a la inversa.
- Evaluar. Enumera las cargas de trabajo, las dependencias, los volúmenes de datos y los costos actuales, y luego marca cada uno como para mover, conservar o reelaborar.
- Elige el objetivo. Elija una plataforma que su equipo pueda utilizar a largo plazo. Considere las habilidades existentes, los costos de licencia y si las máquinas virtuales deben ejecutarse junto con los contenedores, como sucede en KubeVirt y Red Hat OpenShift Virtualization. Muchos equipos eligen una Plataforma basada en KVM como OpenStack u OpenNebula. Dimensionar la capacidad de procesamiento y almacenamiento teniendo en cuenta el crecimiento futuro.
- Reproducir exactamente. Copia las máquinas virtuales y los datos en segundo plano y mantén las copias sincronizadas hasta la transición.
- Prueba. Ejecuta migraciones de prueba en una red aislada para comprobar las integraciones y el orden de arranque sin afectar al entorno de producción.
- Corte. Ejecuta una sincronización incremental final durante una breve ventana de mantenimiento planificada, con un plan de reversión preparado.
- Proteger. Antes de desactivar los recursos en la nube, asegúrese de tener implementados planes de recuperación ante desastres y copias de seguridad para la nueva plataforma.
Riesgos de la migración inversa a la nube y cómo reducirlos
Los problemas en un proyecto de repatriación suelen deberse a costes o dependencias que no se tuvieron en cuenta durante la planificación. La tabla enumera los más comunes y cómo reducirlos.
| Riesgo | Cómo reducirlo |
|---|---|
| Dependencias ocultas de los servicios gestionados en la nube | Mapea las dependencias con anticipación y planifica reemplazos para bases de datos, colas y servicios de identidad propietarios. |
| Costos subestimados de hardware y personal | Incluya los ciclos de renovación, la capacidad de reserva y los salarios de las operaciones en el modelo TCO. |
| Tiempo de inactividad durante la transición | Replique continuamente y practique con migraciones de prueba, para que el cambio final se mantenga breve. |
| Pérdida de capacidad de respuesta tras abandonar la nube multirregional | Configure la recuperación ante desastres en un segundo sitio; una región de nube pública funciona. |
| Costos de salida durante la mudanza | Verifique las exenciones del proveedor y presupueste el tráfico si algunas cargas de trabajo permanecen en la nube. |
| Brecha de habilidades | Capacite al equipo antes de la transición o contrate a un proveedor de servicios gestionados. |
Ejemplos reportados públicamente: 37signals, Dropbox y GEICO.
Tres empresas han descrito sus traslados con sus propias palabras. Cada una trasladó una proporción diferente de su carga de trabajo.
37 señales
Dropbox
GEICO
Cómo la plataforma Hystax admite la repatriación a la nube
La plataforma abarca el aspecto técnico de la repatriación: el traslado en sí, la recuperación ante desastres y la copia de seguridad posterior.
Hystax Migration traslada máquinas virtuales de AWS, Azure, Google Cloud y Oracle Cloud a plataformas privadas, soberanas y de virtualización. En el caso de fuentes de nube pública, un agente de replicación se ejecuta dentro de cada sistema operativo invitado y copia los datos en segundo plano mientras la producción sigue en funcionamiento. Tras la primera copia, solo los bloques modificados se transmiten por la red.
- Los objetivos compatibles incluyen: OpenStack, Servicios Red Hat OpenStack en OpenShift, Nebulosa abierta, Apache CloudStack, KubeVirt, Virtualización de Red Hat OpenShift, Oracle Linux KVM, Oracle Linux Virtualization Manager, Virtuozzo, CloudSigma, STACKIT, VMware y oVirt.
- Direct2Target escribe los datos directamente en los discos de destino sin depender de las API de administración de la plataforma, por lo que cualquier entorno con acceso de escritura a nivel de disco puede servir como destino.
- Las migraciones de prueba se ejecutan en una red aislada, sin límite en la cantidad de migraciones. La transición final tarda entre 1 y 3 minutos en promedio.
- Los planes de migración establecen el orden de arranque y la configuración de red, de modo que las aplicaciones se inicien en la secuencia correcta.
Constructor Group, un ecosistema global de investigación, educación y tecnología, utilizó Hystax Migration para trasladar sus cargas de trabajo de Google Cloud a Virtuozzo. La empresa citó los costos a largo plazo y la dependencia de la plataforma como razones para marcharse, y buscaba una plataforma que pudiera controlar y personalizar por completo. Sus aplicaciones permanecieron en línea durante toda la transición.
Hystax Disaster Recovery protege las cargas de trabajo después de la migración. Abandonar un proveedor de hiperescaladores no significa renunciar a la nube pública como red de seguridad: con recuperación ante desastres entre nubes, AWS, Azure o Google Cloud pueden servir como sitio de recuperación. Allí se almacenan réplicas como volúmenes e instantáneas, y las máquinas virtuales completas solo se inician cuando son necesarias.
Para una retención más prolongada, Hystax Backup escribe los puntos de restauración en almacenamiento de objetos compatible con S3 o en recursos compartidos NFS y Samba. En el almacenamiento compatible con S3 configurado con Bloqueo de objetos, los puntos de restauración permanecen inmutables durante el período de retención.
Puede implementar el software en su propio entorno, por lo que los datos de replicación permanecen bajo su control. Los proveedores de servicios gestionados obtienen un portal de socios multiusuario para ejecutar varios proyectos de clientes a la vez. Los escenarios de migración compatibles se enumeran en el migración a las nubes página.
Cuéntenos sobre su entorno. Nuestros ingenieros analizarán las opciones para sus plataformas de origen y destino, incluyendo la recuperación ante desastres tras la migración.
¡Gracias por tu solicitud!
Nos pondremos en contacto contigo pronto.
Preguntas frecuentes
¿Qué es la repatriación a la nube en términos sencillos?
Esto implica trasladar cargas de trabajo o datos de una nube pública a una infraestructura controlada por la empresa. Por ejemplo, una base de datos con una carga constante podría migrar de AWS a una nube privada OpenStack.
¿La migración inversa a la nube es lo mismo que la repatriación a la nube?
Ambos términos describen el mismo cambio. El término "salida de la nube" es diferente: implica abandonar completamente un proveedor, y las cargas de trabajo pueden trasladarse a las instalaciones de la empresa o a otra nube.
¿La repatriación a la nube siempre supone un ahorro?
No. Los ahorros se obtienen con cargas de trabajo estables y predecibles a gran escala. Las cargas de trabajo con picos repentinos pueden resultar más costosas, al igual que los proyectos que subestiman los costos de hardware, personal o migración. Primero, elabore un modelo de costo total de propiedad (TCO) de tres a cinco años.
¿Cuánto tiempo dura un proyecto de repatriación?
No existe una cifra típica: la duración depende del número de cargas de trabajo, el volumen de datos y el ancho de banda de la red. El entorno de producción permanece en línea durante la replicación, y la propia transición de Hystax dura, en promedio, de 1 a 3 minutos.
¿Puedo seguir utilizando la nube pública después de la repatriación?
Muchas empresas lo hacen. Una configuración híbrida común mantiene cargas de trabajo estables en una nube privada y utiliza la nube pública para picos repentinos, experimentos y recuperación ante desastres.
¿Necesito agentes para migrar máquinas virtuales desde AWS, Azure o Google Cloud?
Para estas fuentes, sí. Hystax replica las máquinas virtuales de la nube pública mediante un agente instalado en el sistema operativo invitado. La replicación sin agentes en el sistema operativo invitado solo está disponible para fuentes VMware, oVirt y OpenStack.