
Tabla de contenido
- Qué son las pruebas de recuperación ante desastres y por qué un plan no probado no es un plan.
- Tipos de pruebas de recuperación ante desastres
- ¿Con qué frecuencia se debe poner a prueba un plan de recuperación ante desastres?
- Pruebas durante una salida o actualización de VMware
- Cómo elaborar un plan de pruebas de recuperación ante desastres
- Qué medir: RTO, RPO y otros resultados de las pruebas.
- Conmutación por error frente a recuperación: pruebe ambas direcciones
- ¿Por qué fallan las pruebas DR?
- Automatización y orquestación de las pruebas de recuperación ante desastres
- Pruebas de conmutación por error en nubes privadas y plataformas de virtualización.
Las pruebas de recuperación ante desastres consisten en poner a prueba un plan de recuperación ante desastres, desde una simulación hasta una conmutación por error real a un entorno de recuperación, para confirmar que la recuperación cumple con el objetivo de tiempo de recuperación (RTO) y el objetivo de punto de recuperación (RPO) establecidos. Estas pruebas demuestran si el plan funciona según lo previsto, cuánto tiempo tarda realmente la recuperación y cuántos datos se pierden durante el proceso.
Esta guía abarca seis tipos de pruebas, un cronograma de pruebas por nivel, un plan de pruebas de recuperación ante desastres de diez pasos, las métricas que convierten una prueba en evidencia y la automatización de las pruebas de conmutación por error.
Qué son las pruebas de recuperación ante desastres y por qué un plan no probado no es un plan.
Tipos de pruebas de recuperación ante desastres
Las pruebas abarcan desde revisiones de planes hasta paradas de producción completas. NIST SP 800-34 Rev. 1 (2010) distingue dos tipos de ejercicios. Los ejercicios de mesa se basan en debates y no requieren equipo, mientras que los ejercicios funcionales implican que el personal realice tareas de recuperación en un entorno simulado. Los seis tipos que se describen a continuación siguen las prácticas habituales del sector. Una prueba práctica se suele denominar simulacro de recuperación ante desastres.
| Tipo de prueba | Qué comprueba | Esfuerzo | Riesgo para la producción | Lo que demuestra |
|---|---|---|---|---|
| Revisión/recorrido del plan | Contactos, pasos y dependencias; leer línea por línea | Horas | Ninguno | El documento está completo y actualizado. |
| Ejercicio de mesa | Un escenario de desastre analizado por propietarios de TI y de negocios. | Mediodía | Ninguno | Las personas conocen sus roles y los procedimientos para escalar problemas. |
| Prueba de simulación | Pasos de recuperación seleccionados realizados en un escenario predefinido. | 1-2 días | Bajo | Los equipos pueden ejecutar los procedimientos dentro de un tiempo determinado. |
| Prueba paralela | Los sistemas de recuperación se pusieron en marcha y funcionan junto a la producción. | Varios días | Bajo a medio | Los sistemas se inician y funcionan en la fase de recuperación. |
| Prueba de interrupción completa | La producción se detuvo y la actividad comercial se desarrolla desde el centro de recuperación. | Semanas de planificación | Alto | Recuperación de extremo a extremo, incluyendo la reversión a fallos. |
| Conmutación por error de prueba sin interrupciones | Las cargas de trabajo se recuperaron en una red aislada mientras se ejecutaban las producciones. | Horas una vez automatizado | Muy bajo, si la red de prueba está aislada. | RTO real, orden de arranque y coherencia de los datos |
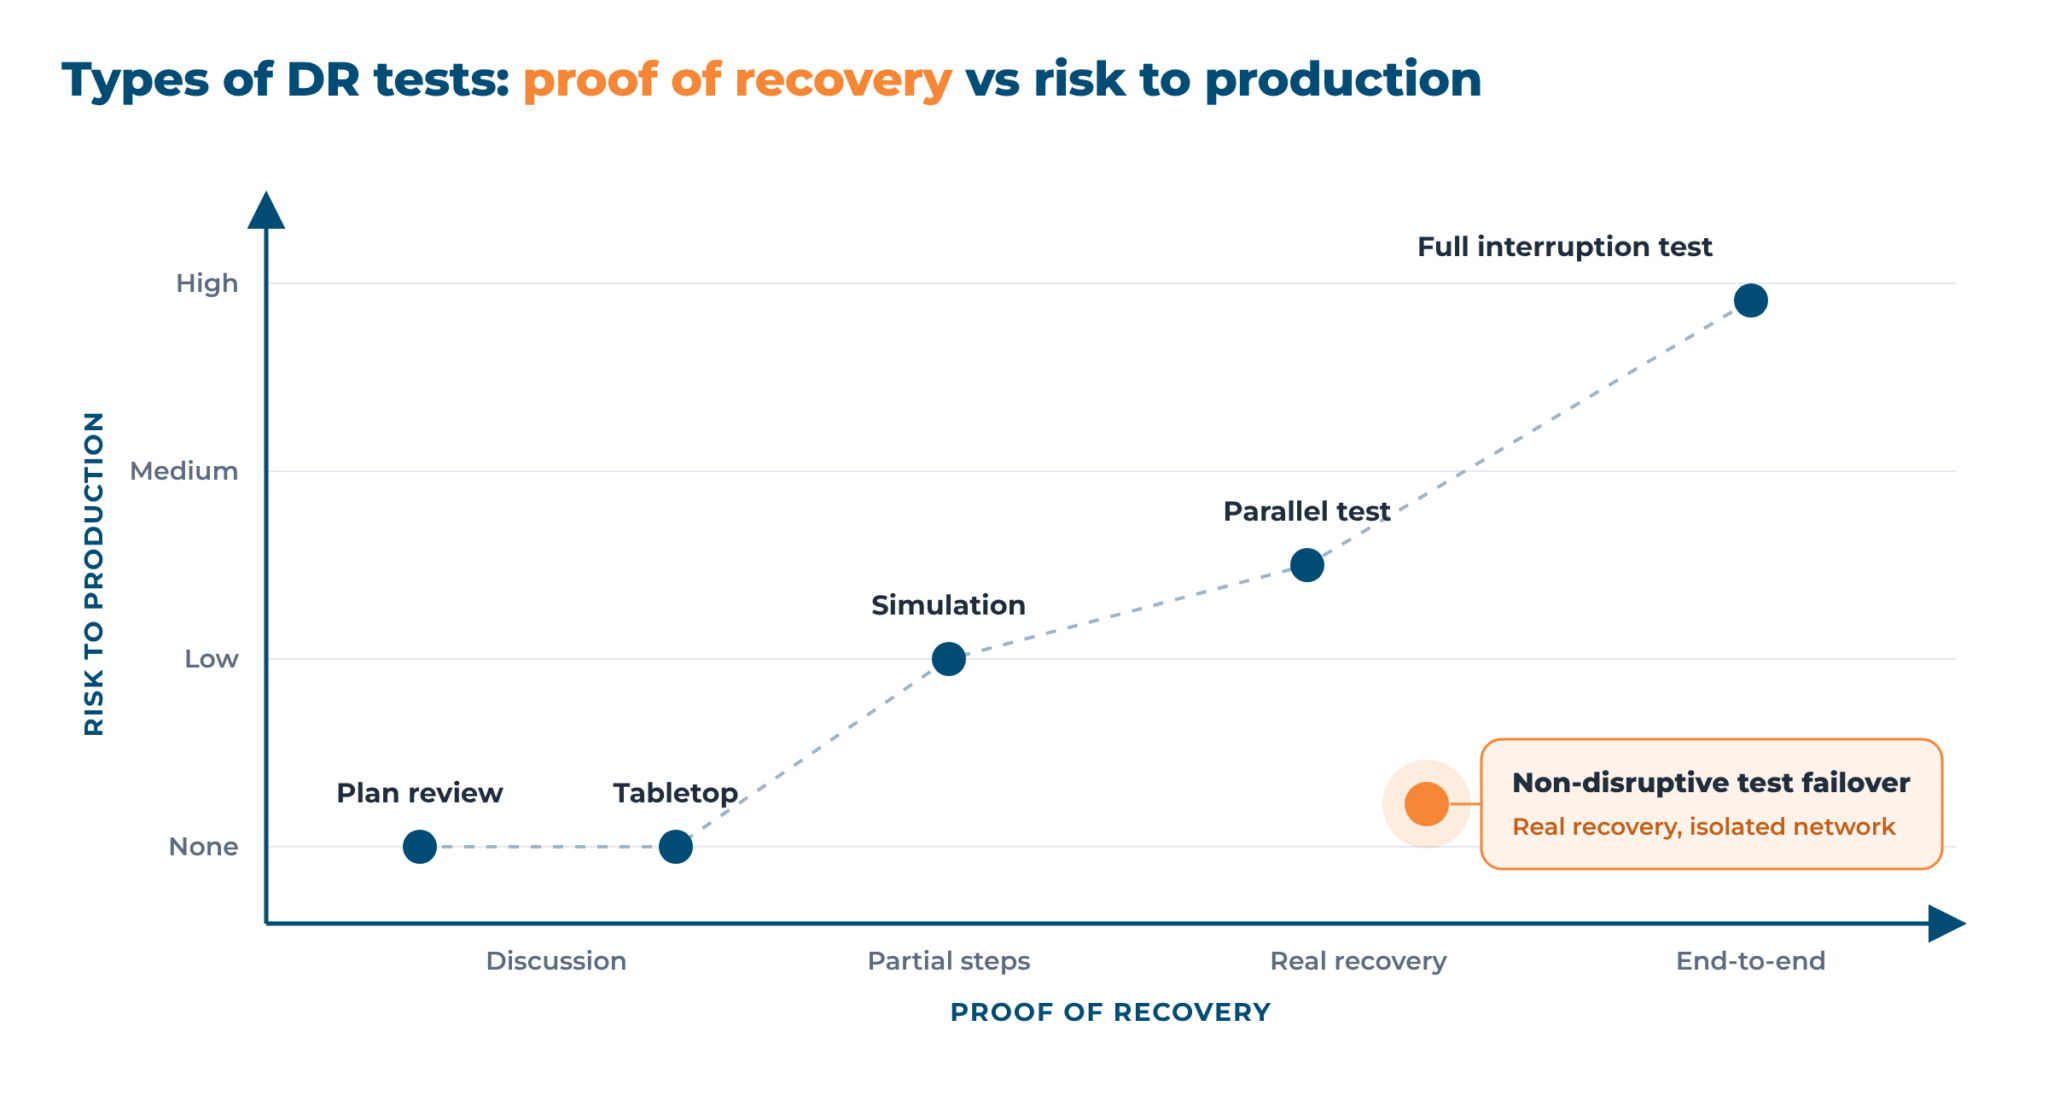
Una prueba paralela y una conmutación por error de prueba sin interrupciones son similares. La conmutación por error de prueba es una forma automatizada de la prueba paralela que ofrecen las herramientas modernas de recuperación ante desastres. Se diferencian en el entorno de recuperación: una prueba paralela se ejecuta junto al entorno de producción, por lo que las redes y los flujos de datos compartidos requieren una gestión cuidadosa, mientras que una conmutación por error de prueba se ejecuta en una red aislada, desconectada del entorno de producción.
Para el aspecto comercial, vea cómo Estrategias de continuidad empresarial y recuperación ante desastres conjugarse.
¿Con qué frecuencia se debe poner a prueba un plan de recuperación ante desastres?
Lo habitual es realizar una prueba al año por cada sistema crítico, y otra después de cualquier cambio importante. Los sistemas de nivel 1 se prueban con mayor frecuencia.
Una prueba de conmutación por error es económica de repetir y no afecta a la producción cuando la red de prueba está aislada, por lo que las ejecuciones trimestrales son realistas.
La tabla es un calendario inicial que los equipos adaptan.
| Nivel | Ejemplos de cargas de trabajo | Tipo de prueba | Frecuencia | Prueba no planificada después |
|---|---|---|---|---|
| Nivel 1, crítico | Bases de datos principales, pagos, aplicaciones de cara al cliente e identidad. | Prueba de conmutación por error y de mesa, además de una prueba de interrupción completa donde la empresa lo permita. | Prueba de conmutación por error trimestralmente; prueba de mesa y prueba de interrupción completa anualmente. | Cambio importante, migración de plataforma, prueba fallida o hallazgo de auditoría interna |
| Nivel 2, importante | Informes ERP, aplicaciones empresariales internas y servicios de archivos. | Conmutación por error de prueba sin interrupciones | Dos veces al año | Cambios en la aplicación o sus dependencias |
| Nivel 3, aplazable | Desarrollo y pruebas, archivos y herramientas que toleran días de inactividad. | Revisión/recorrido del plan | Anual | Cambiar a un nuevo sistema de almacenamiento o a un nuevo hipervisor. |
Programación de pruebas por nivel de carga de trabajo
Pruebas durante una salida o actualización de VMware
infraestructura, pruebas automatizadas configuradas en el plan y retorno a producción
¡Gracias por tu solicitud!
Nos pondremos en contacto contigo pronto.
Cómo elaborar un plan de pruebas de recuperación ante desastres
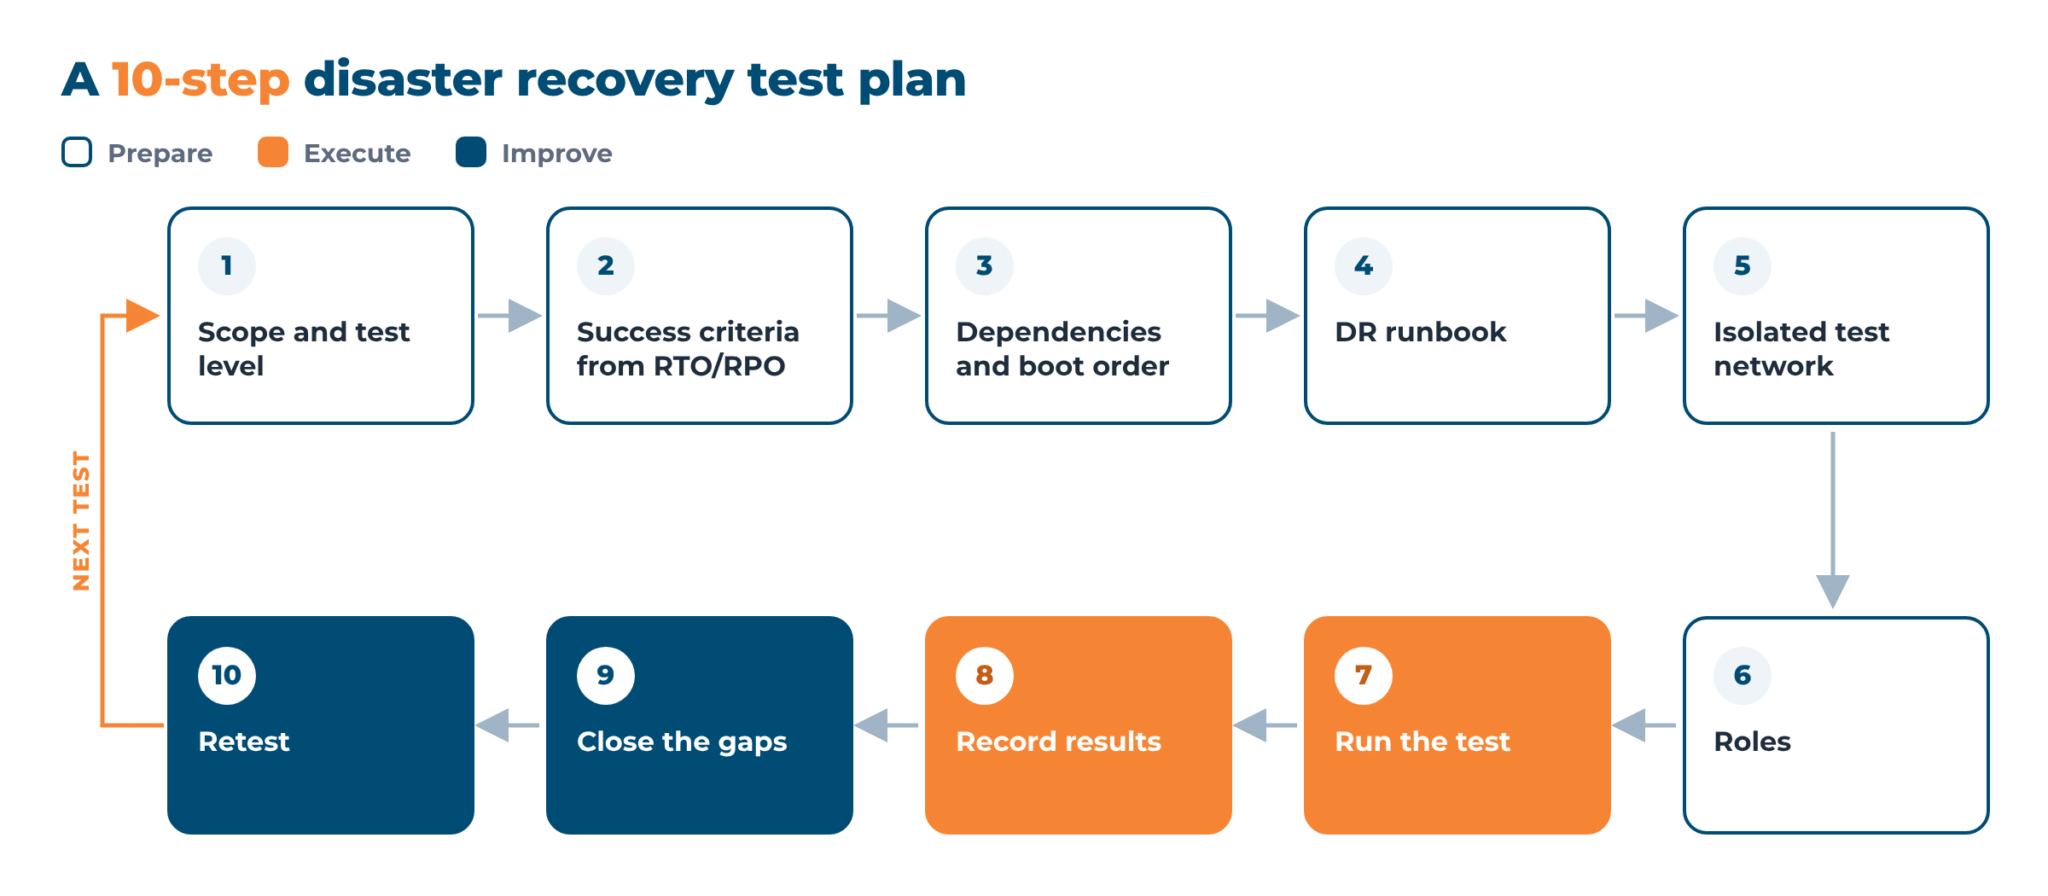
Un plan sólido de pruebas de recuperación ante desastres define cuatro aspectos: qué se prueba, cómo se evalúa el éxito, quién hace qué y adónde van los resultados.
Los diez pasos se presentan también como una plantilla y una lista de verificación para el plan de pruebas de recuperación ante desastres.
- Defina el alcance y el nivel de las pruebas. Seleccione los sistemas, su nivel y un tipo de prueba de las tablas anteriores. Añada al menos un escenario de ransomware, con recuperación a partir de una copia limpia.
- Definir los criterios de éxito de RTO y RPO. Escriba un criterio de aprobación para cada sistema, por ejemplo, que funcione en 60 minutos con una pérdida de datos máxima de 15 minutos.
- Mapea las dependencias de la aplicación y el orden de arranque. Enumere los requisitos de cada sistema, como bases de datos, servicios de directorio, DNS, servidores de licencias y reglas de firewall, así como el orden en que se inician.
- Redacte el manual de procedimientos para la recuperación ante desastres. Un manual de recuperación ante desastres (DR runbook) es el procedimiento de recuperación paso a paso. Indica los responsables, los resultados esperados y el lugar donde se guardan las credenciales, y cualquier persona, incluso sin haberlo redactado, debería poder seguirlo.
- Prepare una red de prueba aislada. Cree un entorno de pruebas sin conexión con producción, de modo que las direcciones IP y los nombres de host duplicados no puedan entrar en conflicto con los sistemas en producción.
- Asignar roles. Necesitas un responsable de pruebas y un propietario para cada sistema, además de un observador para registrar los tiempos y un representante de la empresa para dar su aprobación.
- Ejecuta la prueba. Siga el manual de procedimientos al pie de la letra y registre las horas de inicio y finalización, cualquier desviación y cualquier corrección manual.
- Registra los resultados. El informe de la prueba abarca el alcance, la fecha, los objetivos, los valores medidos, los fallos y los riesgos pendientes.
- Cerrar las brechas. Corrija el manual de procedimientos, la configuración, las credenciales o las licencias, y asigne un responsable y una fecha límite a cada hallazgo.
- Repetir la prueba. Repite lo que haya fallado, actualiza el plan y programa la siguiente prueba.
Qué medir: RTO, RPO y otros resultados de las pruebas.
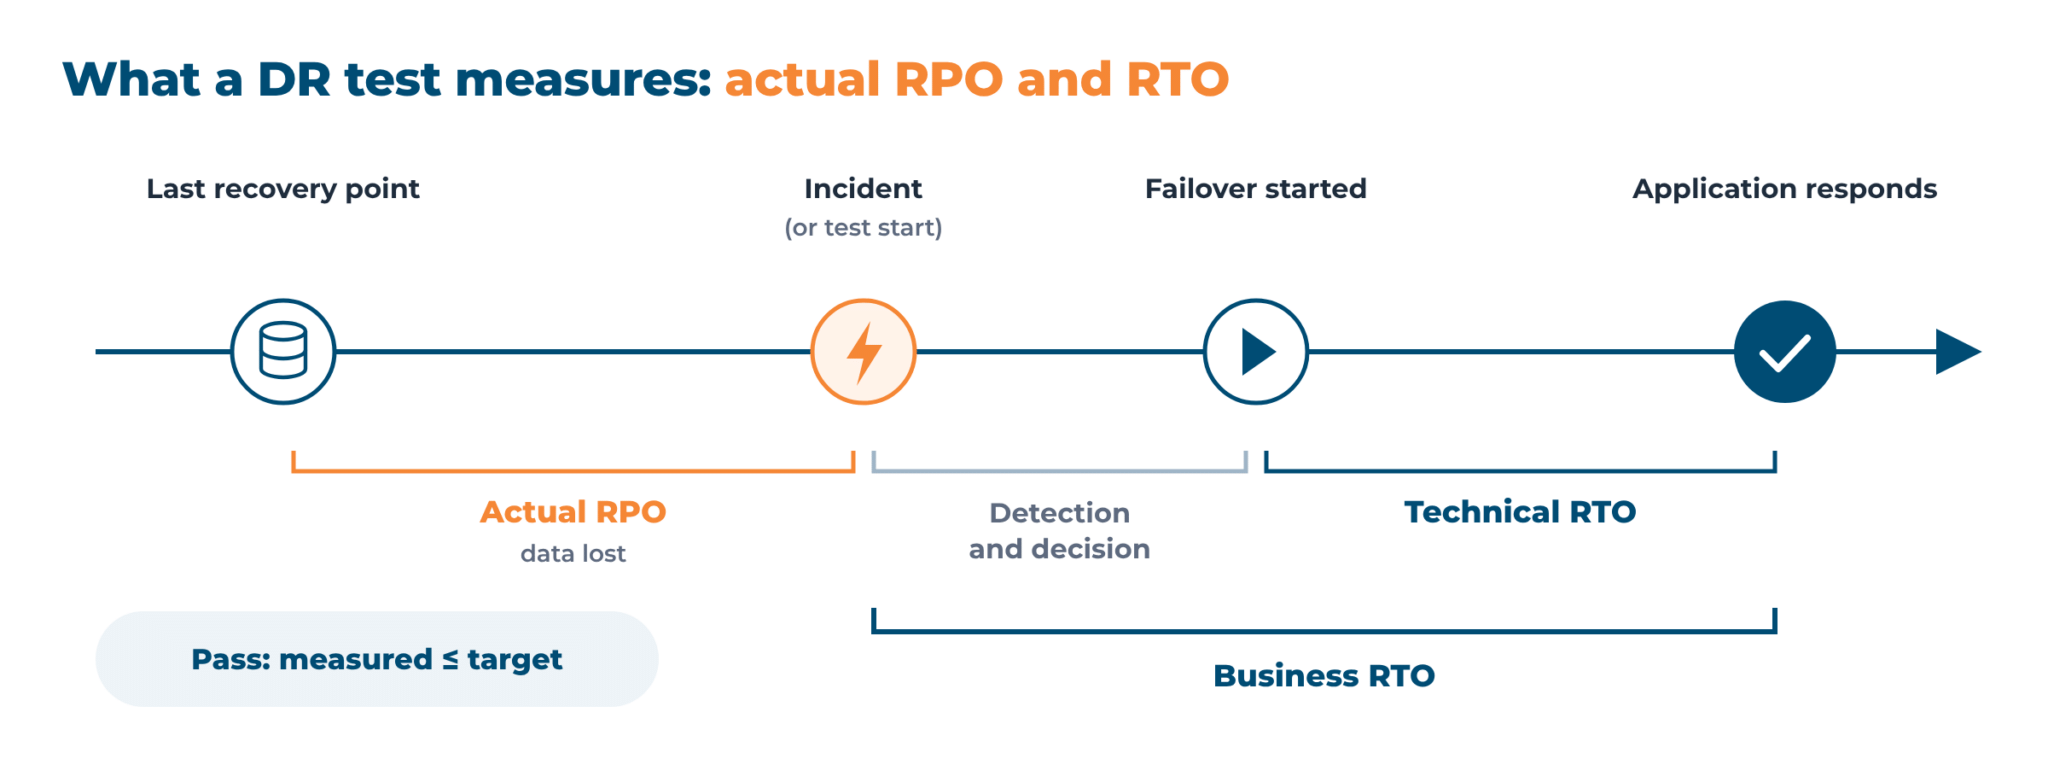
RTO y RPO, los objetivos de recuperación, son solo metas hasta que una prueba los mida. Diferencia entre RTO y RPO Tiene su propio artículo, así que esta sección trata sobre la medición. Seis métricas son suficientes.
| Métrico | Cómo se mide en la prueba | Criterio de aprobación | Fallo típico |
|---|---|---|---|
| RTO real | Tiempo transcurrido desde el comando de conmutación por error hasta que la aplicación responde a una solicitud de prueba (RTO técnico); el RTO empresarial también incluye el tiempo de detección y decisión. | El tiempo de respuesta técnico más el tiempo de detección y decisión es igual o inferior al tiempo de respuesta empresarial. | Restauración lenta del disco, orden de arranque incorrecto, pasos manuales |
| RPO real | Antigüedad de los datos más recientes en el sistema recuperado, en comparación con el momento en que se inició la prueba de conmutación por error. | Igual o inferior al RPO objetivo | Retraso en la replicación, programación omitida, punto de recuperación anterior al previsto. |
| Verificación de integridad de datos | Sumas de verificación, recuentos de filas o consultas comparadas con la fuente | No hay registros corruptos o faltantes. | Copia consistente ante fallos de una base de datos ocupada; las instantáneas consistentes con la aplicación lo evitan. |
| Verificación del estado a nivel de aplicación | Inicio de sesión, una transacción clave y una llamada a la API, de principio a fin. | Todas las transacciones críticas pasan | La máquina arranca, pero la aplicación no puede acceder al DNS, a la base de datos ni al servidor de licencias. |
| Tiempo de recuperación | Es hora de devolver las cargas de trabajo y los datos modificados a producción. | Dentro del período de mantenimiento planificado | La función de recuperación ante fallos nunca se ha probado, debido al gran volumen de cambios. |
| Intervenciones manuales | Número de pasos realizados fuera del manual de procedimientos o la automatización. | Cada paso documentado | Soluciones conocidas solo por un ingeniero. |
Métricas para una prueba DR, con criterios de aprobación y fallos típicos.
Conmutación por error frente a recuperación: pruebe ambas direcciones
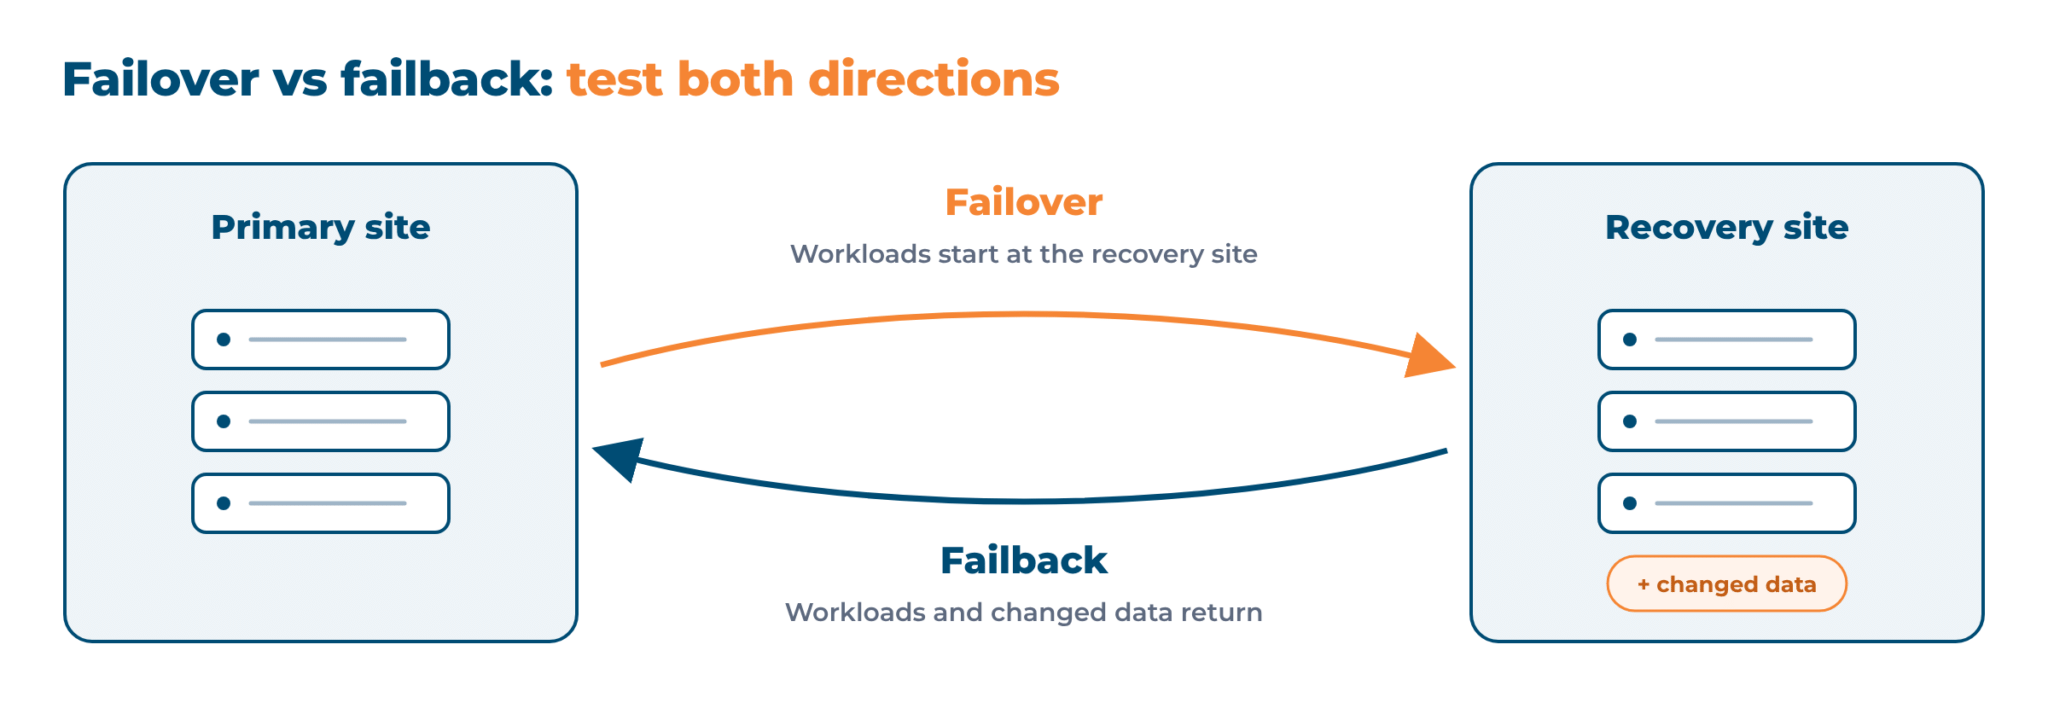
La conmutación por error traslada las cargas de trabajo al sitio de recuperación, y la recuperación las devuelve una vez reparado el sitio principal, con los datos modificados durante ese tiempo. Las pruebas de conmutación por error son rutinarias, pero la recuperación se suele pasar por alto, por lo que la primera recuperación real no se prueba. La prueba anual de interrupción total es el momento idóneo para incluirla y cronometrarla. Cuando no es posible detener la producción, la alternativa más cercana es una prueba de conmutación por error y recuperación de toda la infraestructura en un entorno aislado.
¿Por qué fallan las pruebas DR?
La recuperación a menudo no alcanza sus objetivos. Encuesta de Veeam sobre las tendencias de protección de datos de 2024 De 1200 líderes de TI encuestados, informaron que solo el 58% de los servidores cumplieron con su SLA de recuperación en el último ataque a gran escala. Siete causas son comunes.
- El lugar de recuperación difiere del de producción. Los cambios llegan a producción, pero no al lugar de recuperación.
- Las dependencias permanecen sin verificar. Se da por sentado que los servicios DNS, los servicios de directorio, los servidores de licencias y las API de terceros funcionan correctamente.
- No existe una red aislada. Los equipos temen colisiones con sistemas en funcionamiento y siguen posponiendo la prueba, aunque un entorno de pruebas reduce el riesgo.
- Las credenciales y las licencias caducan. Las cuentas de servicio, los certificados y las claves de licencia caducan entre las pruebas.
- El manual de procedimientos pertenecía a alguien que se marchó. Nadie más conoce los pasos no escritos.
- Nunca se establecieron criterios de éxito. Un servidor que arranca cuenta como un pase.
- Solo se prueba la infraestructura. La máquina virtual se inicia, pero nadie comprueba que la aplicación funcione.
Revertir estas causas constituye la base de las mejores prácticas para las pruebas de recuperación ante desastres.
Automatización y orquestación de las pruebas de recuperación ante desastres
Las pruebas manuales funcionan bien con pocas máquinas. Con más máquinas, el manual de procedimientos se vuelve extenso y cada vez se ejecuta de forma lenta y diferente. La automatización de la recuperación ante desastres traslada los pasos individuales al software: replicación de datos, inicio de máquinas y verificación del resultado.
La orquestación de la recuperación ante desastres coordina los pasos de una secuencia de recuperación: qué máquinas se inician primero y cuáles esperan, a qué red se conecta cada una y qué comprobación de estado completa un paso.
La misma secuencia impulsa posteriormente la conmutación por error real. En la encuesta de Veeam sobre tendencias de protección de datos de 2024, solo el 13 % de las organizaciones utilizaba flujos de trabajo orquestados en sus procesos de recuperación ante desastres.
La automatización también hace que la conmutación por error de prueba sin interrupciones sea práctica. La replicación mantiene una copia de cada máquina protegida en el sitio de recuperación. En el momento de la prueba, la herramienta crea máquinas a partir de un punto de recuperación o instantánea elegido dentro de una red de prueba aislada. La producción continúa funcionando y las máquinas de prueba se eliminan cuando finalizan las comprobaciones.
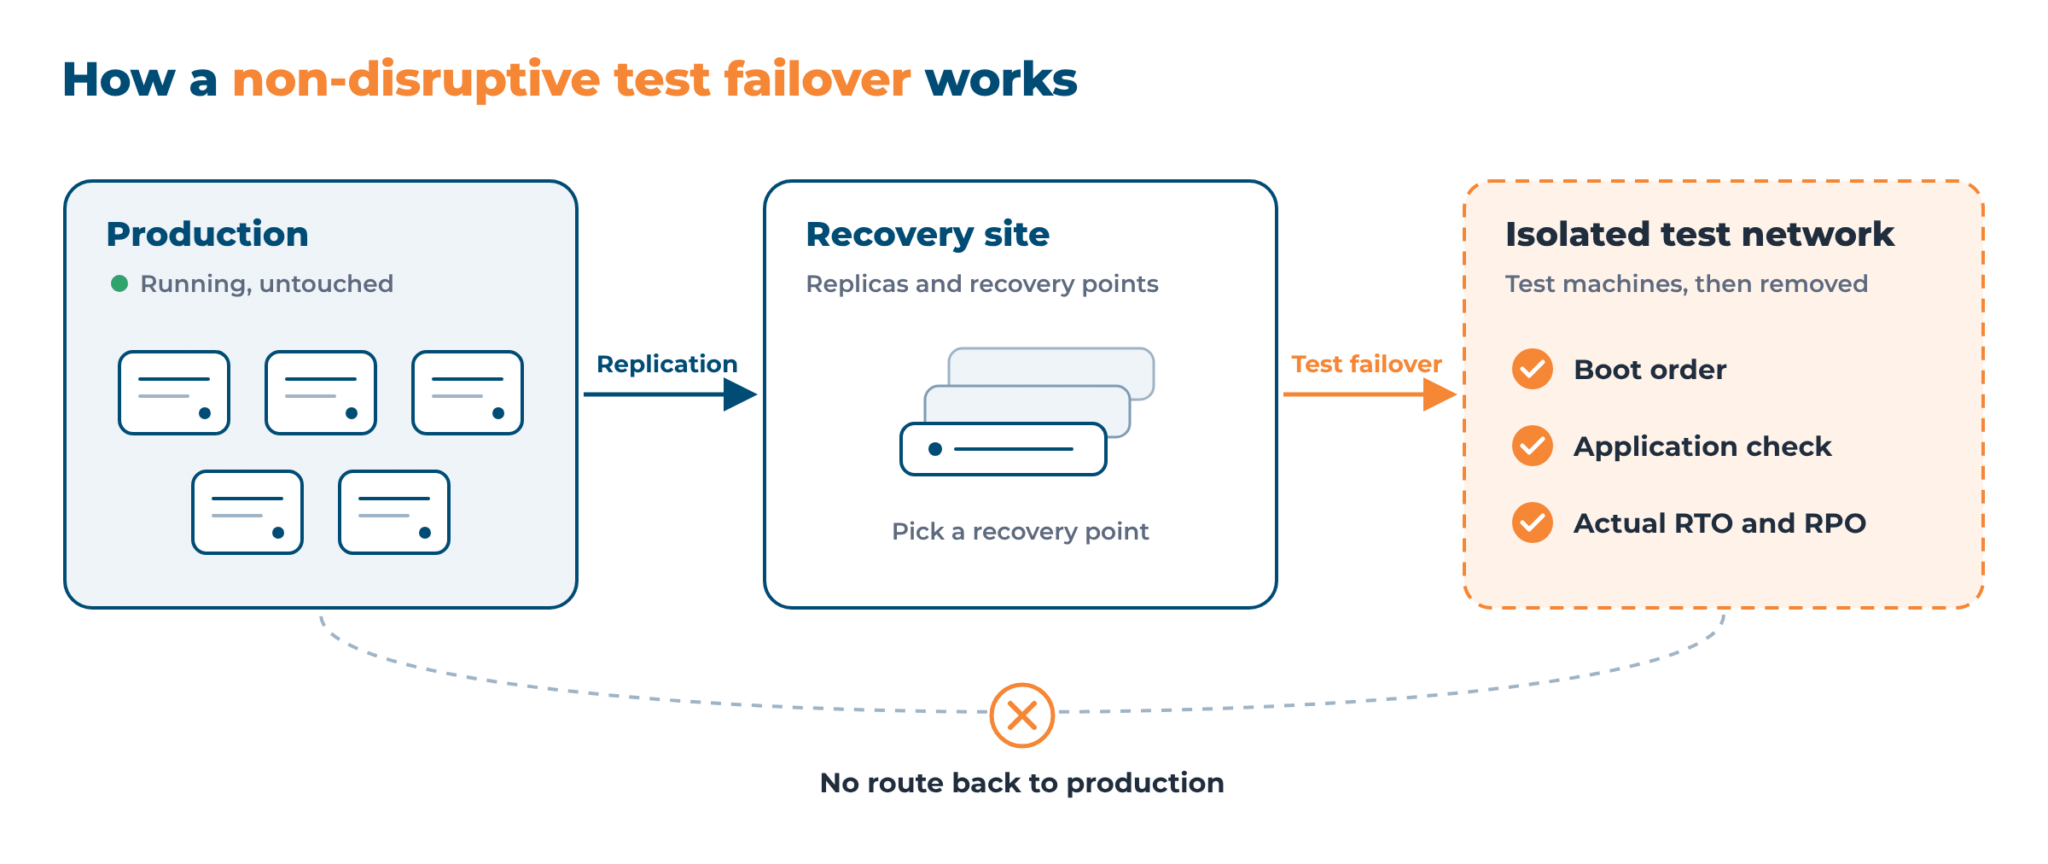
En las herramientas que admiten pruebas programadas, se puede ejecutar una conmutación por error de la prueba sin supervisión cada trimestre, y cada ejecución genera un informe con los tiempos, el RTO medido y los pasos fallidos para que los auditores los revisen.
Pruebas de conmutación por error en nubes privadas y plataformas de virtualización
Recuperación ante desastres de Hystax, parte de la plataforma Hystax, admite dos modos de replicación:
- La replicación sin agente funciona a nivel de plataforma mediante un agente externo de Hystax, sin necesidad de instalar nada en el sistema operativo invitado. Está disponible para VMware, OpenStack y oVirt.
- La replicación basada en agentes utiliza un agente de Windows o Linux dentro del sistema operativo invitado y abarca otros hipervisores, máquinas virtuales en nubes públicas y servidores físicos.
Los planes de recuperación ante desastres se generan a partir de la infraestructura replicada, y se pueden configurar pruebas automatizadas dentro del plan.
En Virtualización de Red Hat OpenShift, Por ejemplo, los equipos pueden validar planes en un entorno aislado en cualquier momento sin afectar las cargas de trabajo de producción. Para el escenario de ransomware del paso 1 del plan de prueba, la función integrada protección contra ransomware Indica un volumen anormal de datos modificados durante la replicación.
La plataforma coloca entonces la máquina en estado suspendido: deja de crear nuevos puntos de restauración y no aplica la política de retención, por lo que los puntos de restauración limpios anteriores permanecen disponibles.
Los destinos de recuperación incluyen OpenStack, VMware, KVM, Red Hat OpenShift Virtualization, Virtuozzo, oVirt, OpenNebula y KubeVirt, además de AWS, Azure, Google Cloud (GCP) y Alibaba Cloud. La recuperación al sitio principal está integrada. La recuperación también puede ejecutarse a través de las nubes.
Adam Data Center, un proveedor español independiente de IaaS con centros de datos en Madrid y Barcelona, añadió recuperación ante desastres a su Nube basada en OpenStack con Hystax. Según el Estudio de caso de marzo de 2026, Los sistemas de destino arrancan individualmente o en grupos, respetando las dependencias, y se pueden implementar y validar entornos de contingencia sin detener la producción.
Hable con los ingenieros de Hystax sobre las pruebas de los planes de recuperación en la pila que utiliza.
¡Gracias por tu solicitud!
Nos pondremos en contacto contigo pronto.
Preguntas frecuentes
¿Qué son las pruebas de recuperación ante desastres?
Las pruebas de recuperación ante desastres consisten en poner a prueba un plan de recuperación para verificar que la recuperación cumpla con los objetivos de tiempo de recuperación (RTO) y punto de recuperación (RPO) establecidos. La prueba puede ser una discusión en equipo o una conmutación por error real. Permite detectar dependencias obsoletas, credenciales caducadas y pasos faltantes antes de que se produzca una interrupción real del servicio.
¿Qué tipos de pruebas de DR existen?
Existen seis tipos comunes: revisión de planes, ejercicio de mesa, prueba de simulación, prueba paralela, prueba de interrupción total y prueba de conmutación por error sin interrupciones. El rango abarca desde una discusión hasta una parada completa de la producción. La mayoría de los equipos combinan varios tipos, realizando pruebas más seguras con frecuencia y pruebas más exigentes anualmente.
¿Con qué frecuencia se debe poner a prueba un plan de recuperación ante desastres?
El procedimiento básico consiste en una prueba anual por sistema crítico, más una tras cambios importantes como la migración de una plataforma. Las cargas de trabajo críticas pueden probarse trimestralmente con conmutación por error, ya que, al estar aisladas en una red de pruebas, no afectan a la producción. DORA exige pruebas anuales para las entidades financieras de la UE.
¿Qué es una conmutación por error de prueba sin interrupciones?
Una conmutación por error de prueba sin interrupciones recupera las cargas de trabajo a partir de datos replicados en una red de prueba aislada mientras la producción continúa en funcionamiento. Los usuarios de producción no se ven afectados. Posteriormente, se retiran las máquinas de prueba para que los equipos puedan medir el tiempo de recuperación real y verificar las aplicaciones con la frecuencia necesaria.
¿Quién es el responsable de las pruebas de DR?
El propietario de TI o de la infraestructura lidera la prueba, los propietarios del sistema ejecutan sus pasos de recuperación y un representante comercial aprueba el resultado. La gerencia es responsable de los objetivos de recuperación. Con DRaaS, El proveedor se encarga de gran parte de las pruebas, pero el cliente sigue validando las aplicaciones y aprobando los resultados.
¿Cuál es la diferencia entre conmutación por error y recuperación ante fallos?
La conmutación por error traslada las cargas de trabajo del sitio principal al sitio de recuperación, ya sea en caso de una interrupción real o durante una prueba. La recuperación automática las devuelve una vez reparado el sitio principal, junto con los datos modificados durante ese tiempo. Es necesario probar ambas direcciones, ya que solo una recuperación automática probada permite comprobar si los datos modificados se devuelven intactos.
¿Qué debe contener un informe de prueba de DR?
Un informe de pruebas de recuperación ante desastres registra el alcance, la fecha y el tipo de prueba, el RTO y el RPO objetivo y medido, los resultados de la verificación de datos y aplicaciones, el tiempo de recuperación, las intervenciones manuales, los pasos fallidos y los riesgos pendientes. Cada hallazgo tiene un responsable y una fecha límite. Además, sirve como evidencia de auditoría.
Un plan de recuperación es tan bueno como su última prueba exitosa. Los análisis y las conmutaciones por error reales revelan deficiencias y dependencias faltantes, por lo que el plan se revisa después de cada prueba y cambio importante.
Para conocer los tipos de pruebas, la frecuencia y un plan paso a paso, consulte nuestra guía sobre cómo probar un plan de recuperación ante desastres.