
Índice
- O que é um teste de recuperação de desastres e por que um plano não testado não é um plano.
- Tipos de testes de recuperação de desastres
- Com que frequência um plano de recuperação de desastres deve ser testado?
- Testes durante a saída ou atualização do VMware
- Como elaborar um plano de teste de recuperação de desastres
- O que medir: RTO, RPO e outros resultados de testes.
- Failover versus failback: teste ambas as direções
- Por que os testes de recuperação de desastres falham?
- Automatizando e orquestrando testes de recuperação de desastres
- Testes de failover em nuvens privadas e plataformas de virtualizaçãox
O teste de recuperação de desastres consiste na prática de exercitar um plano de recuperação de desastres, desde uma simulação até uma falha real em um ambiente de recuperação, para confirmar se a recuperação atende aos objetivos de tempo de recuperação (RTO) e ponto de recuperação (RPO) declarados. O teste de recuperação de desastres demonstra se o plano funciona conforme o planejado, quanto tempo a recuperação realmente leva e quanta perda de dados ocorre durante o processo.
Este guia aborda seis tipos de testes, um cronograma de testes por nível, um plano de teste de recuperação de desastres em dez etapas, as métricas que transformam um teste em evidência e a automação de testes de failover.
O que é um teste de recuperação de desastres e por que um plano não testado não é um plano.
Tipos de testes de recuperação de desastres
Os testes variam desde revisões de planos até paralisações completas da produção. NIST SP 800-34 Rev. 1 (2010) distingue dois tipos de exercícios. Os exercícios teóricos são baseados em discussões e não requerem equipamentos, enquanto os exercícios práticos envolvem a execução de tarefas de recuperação por parte da equipe em um ambiente simulado. Os seis tipos descritos abaixo seguem as práticas comuns do setor. Um teste prático é frequentemente chamado de simulado de recuperação de desastres.
| Tipo de teste | O que verifica | Esforço | Risco para a produção | O que isso prova |
|---|---|---|---|---|
| Análise/vistoria do projeto | Contatos, etapas e dependências; leia linha por linha | Horas | Nenhum | O documento está completo e atualizado. |
| Exercício de mesa | Um cenário catastrófico discutido por profissionais de TI e empresários. | Meio dia | Nenhum | As pessoas conhecem seus papéis e os caminhos a seguir para escalonar processos. |
| Teste de simulação | Etapas de recuperação selecionadas executadas em um cenário pré-definido. | 1-2 dias | Baixo | As equipes podem executar os procedimentos dentro de um tempo determinado. |
| Teste paralelo | Os sistemas de recuperação foram iniciados e executados em paralelo com a produção. | Vários dias | Baixo a médio | Os sistemas iniciam e funcionam no lado da recuperação. |
| Teste de interrupção total | Produção interrompida, negócios funcionando a partir do local de recuperação. | Semanas de planejamento | Alto | Recuperação de ponta a ponta, incluindo failback. |
| Failover de teste não disruptivo | As cargas de trabalho foram recuperadas em uma rede isolada durante a execução da produção. | Horas uma vez automatizadas | Muito baixo, se a rede de teste estiver isolada. | RTO real, ordem de inicialização e consistência de dados |
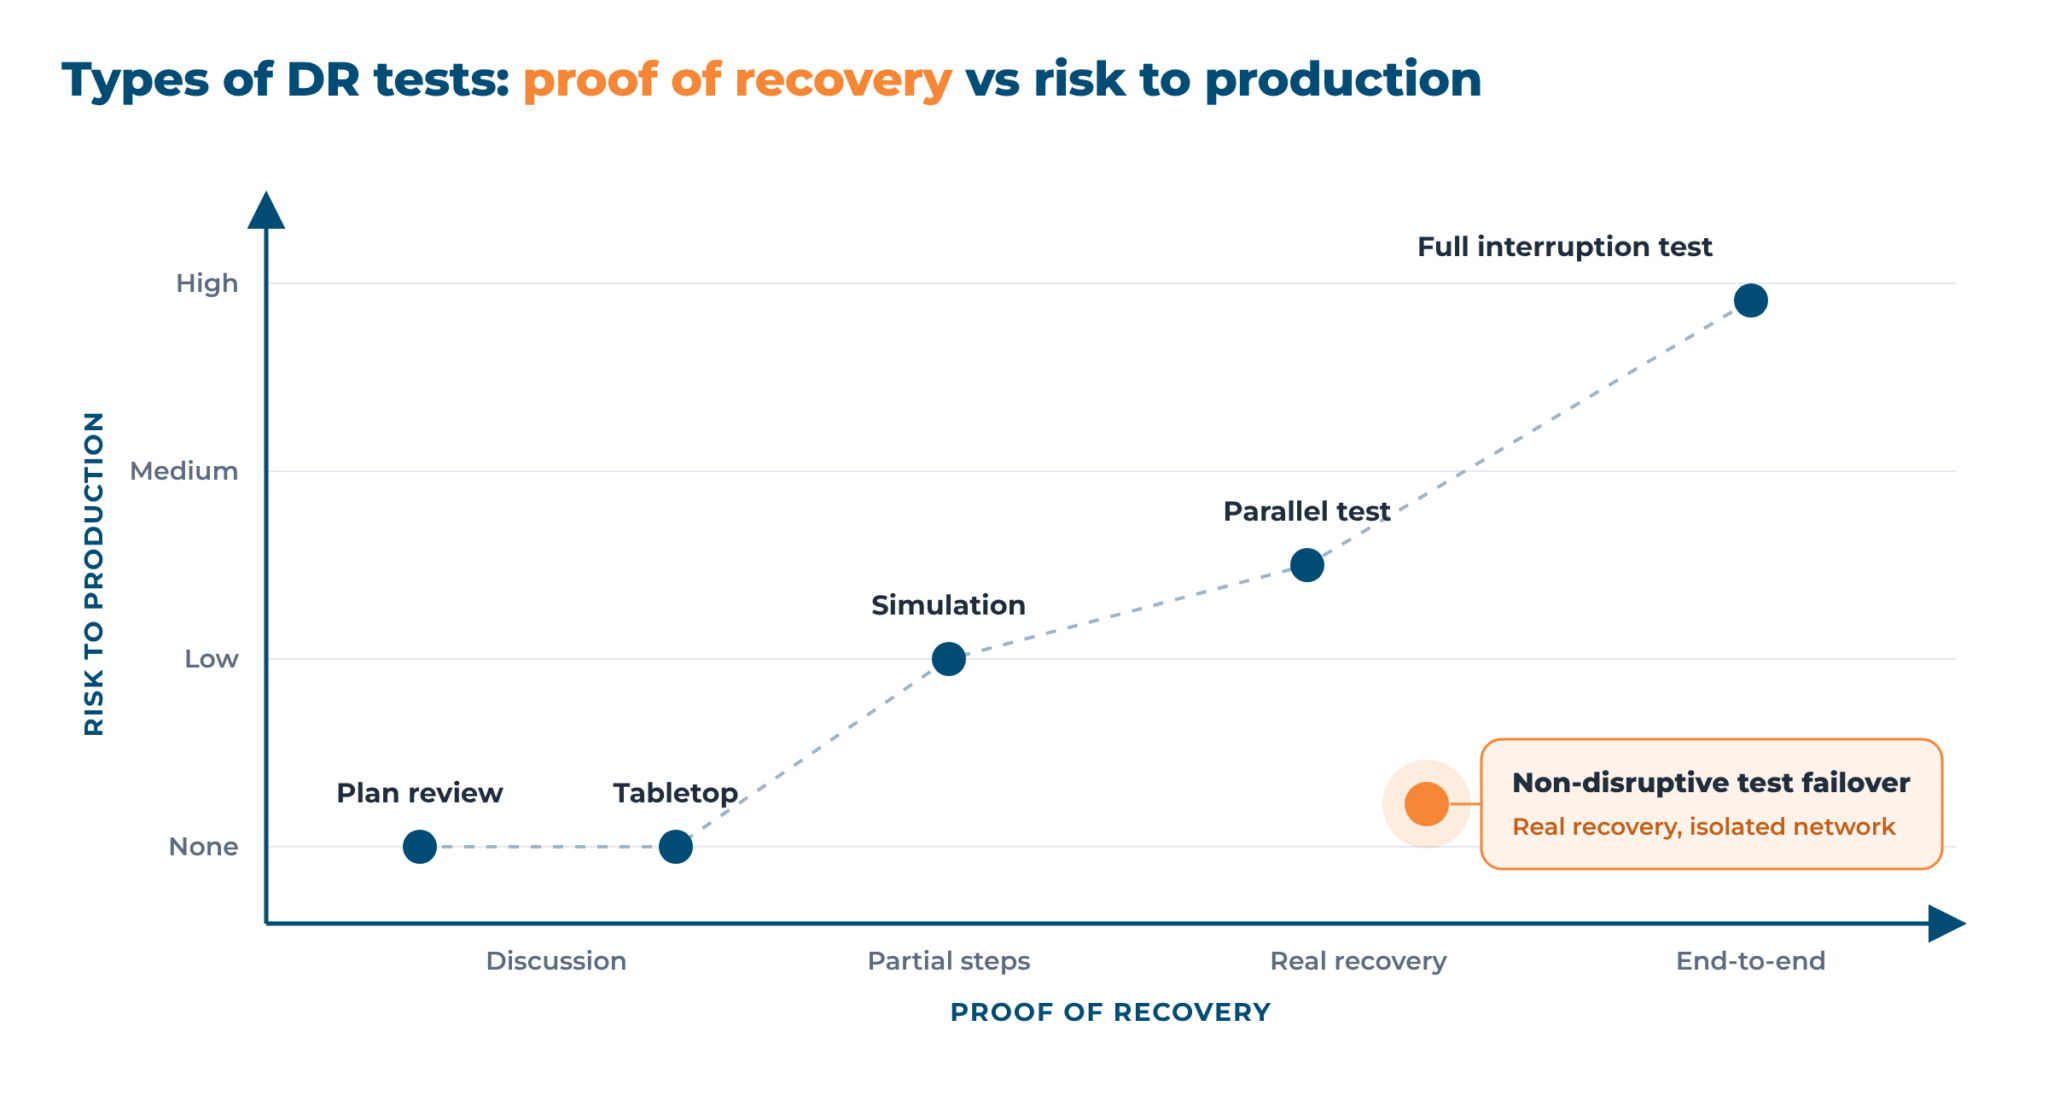
Um teste paralelo e um failover de teste não disruptivo são bastante semelhantes. O failover de teste é uma forma automatizada do teste paralelo oferecida pelas ferramentas modernas de recuperação de desastres (DR). A diferença reside no local onde a recuperação é executada: um teste paralelo é executado próximo à produção, exigindo gerenciamento cuidadoso dos fluxos de dados e redes compartilhados, enquanto um failover de teste é executado em uma rede isolada, desconectada da produção.
Para o lado comercial, veja como estratégias de continuidade de negócios e recuperação de desastres encaixam-se perfeitamente.
Com que frequência um plano de recuperação de desastres deve ser testado?
O padrão usual é um teste por ano para cada sistema crítico e outro após qualquer alteração importante. Sistemas de nível 1 são testados com mais frequência.
Um teste de failover é barato de repetir e não afeta a produção quando a rede de teste está isolada, portanto, execuções trimestrais são viáveis.
A tabela é um cronograma inicial que as equipes adaptam.
| Nível | Exemplos de cargas de trabalho | Tipo de teste | Freqüência | Teste não planejado após |
|---|---|---|---|---|
| Nível 1, crítico | Bancos de dados principais, pagamentos, aplicativos voltados para o cliente e identidade. | Teste de failover e de mesa, além de um teste completo de interrupção, onde a empresa o permitir. | Teste de failover trimestral; teste de simulação e interrupção completa anual. | Mudança significativa, migração de plataforma, teste reprovado ou constatação de auditoria interna |
| Nível 2, importante | Relatórios ERP, aplicativos de negócios internos e serviços de arquivos. | Failover de teste não disruptivo | Duas vezes por ano | Alteração no aplicativo ou em suas dependências |
| Nível 3, adiável | Desenvolvimento e teste, arquivos e ferramentas que toleram dias de inatividade. | Análise/vistoria do projeto | Anual | Migre para um novo armazenamento ou um novo hipervisor. |
Cronograma de testes por nível de carga de trabalho
Testes durante a saída ou atualização do VMware
Infraestrutura, testes automatizados configurados no plano e failback para produção.
Obrigado pelo seu pedido!
Entraremos em contato em breve.
Como elaborar um plano de teste de recuperação de desastres
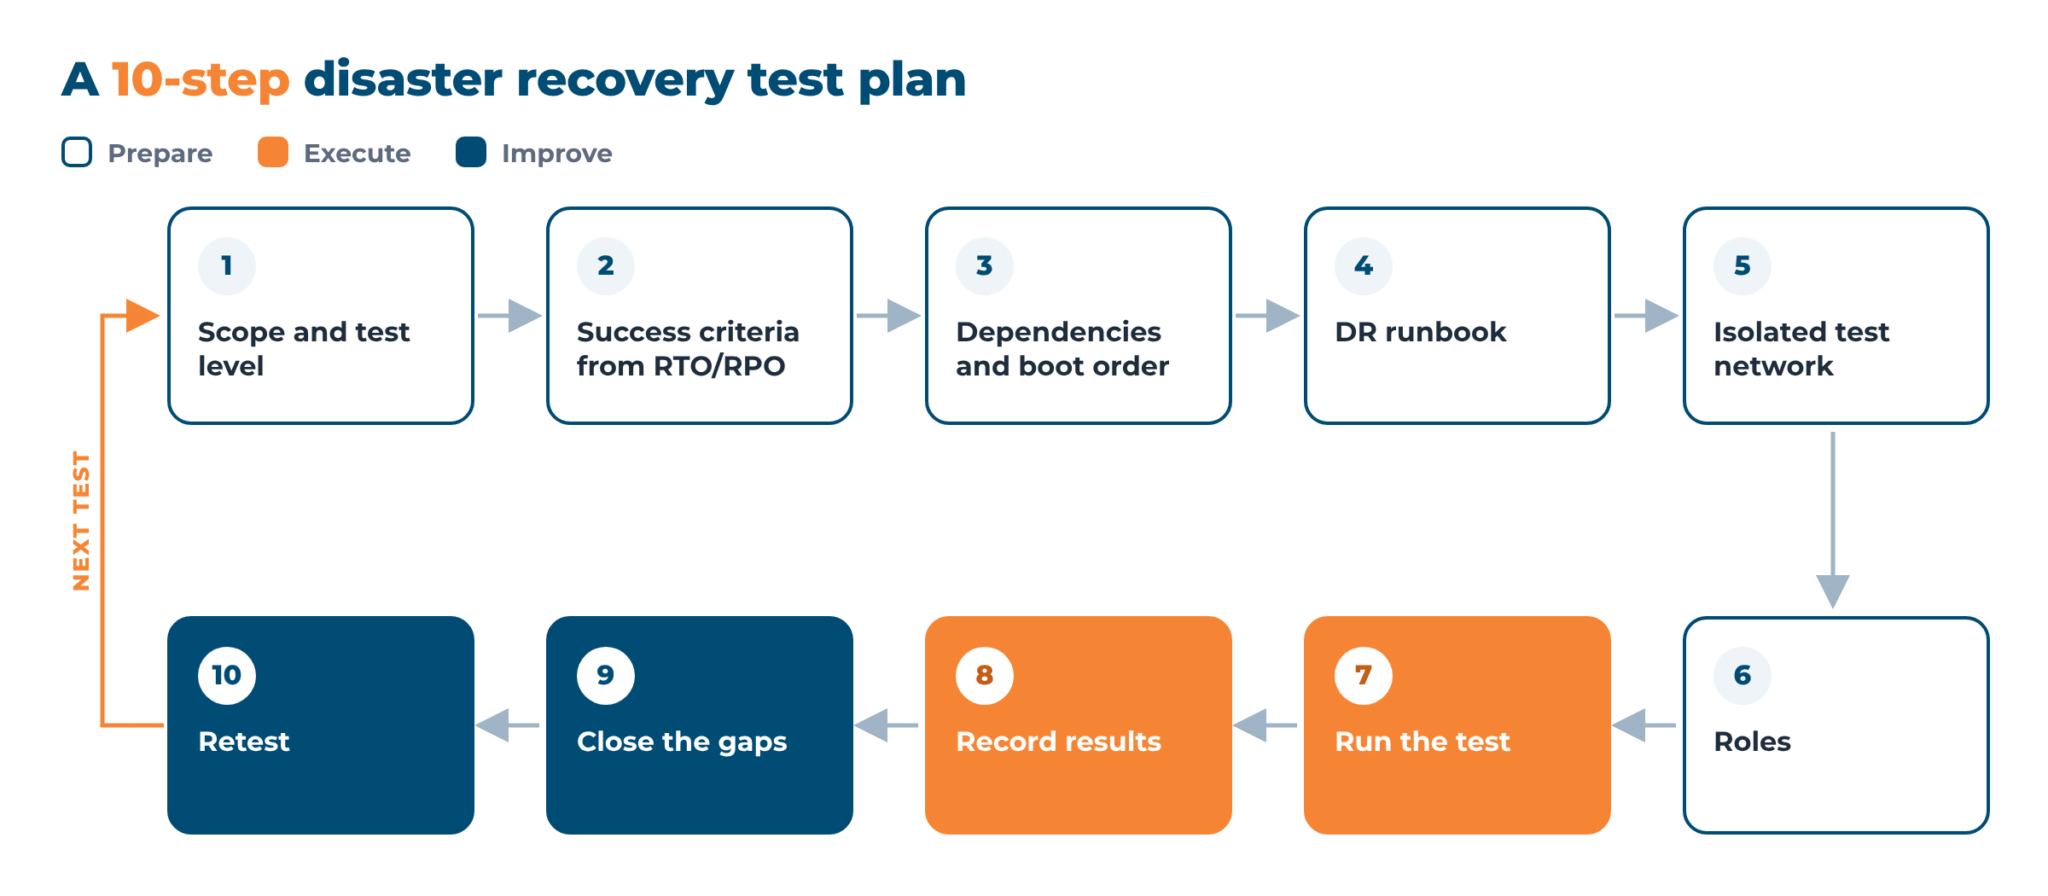
Um plano sólido de testes de recuperação de desastres define quatro coisas: o que é testado, como o sucesso é avaliado, quem faz o quê e para onde vão as descobertas.
Os títulos das dez etapas funcionam também como um modelo e uma lista de verificação para um plano de teste de recuperação de desastres.
- Defina o escopo e o nível de teste. Selecione os sistemas, seus níveis de segurança e um tipo de teste nas tabelas acima. Adicione pelo menos um cenário de ransomware, com recuperação a partir de uma cópia limpa.
- Defina os critérios de sucesso a partir do RTO e do RPO. Defina um critério de aprovação para cada sistema, por exemplo, execução em até 60 minutos com no máximo 15 minutos de perda de dados.
- Mapear dependências de aplicativos e ordem de inicialização. Liste o que cada sistema precisa, como bancos de dados, serviços de diretório, DNS, servidores de licença e regras de firewall, e a ordem em que os sistemas devem ser iniciados.
- Elabore o plano de recuperação de desastres. Um manual de recuperação de desastres (DR runbook) é um procedimento passo a passo para a recuperação. Ele indica os responsáveis, os resultados esperados e o local onde as credenciais são armazenadas, permitindo que qualquer pessoa que não o tenha escrito seja capaz de segui-lo.
- Prepare uma rede de teste isolada. Crie um ambiente de teste (sandbox) sem rota para produção, para que endereços IP e nomes de host duplicados não entrem em conflito com os sistemas em funcionamento.
- Atribua funções. Você precisa de um líder de teste e um responsável por cada sistema, além de um observador para registrar os tempos e um representante da empresa para aprovar o teste.
- Execute o teste. Siga o roteiro à risca e registre os horários de início e término, cada desvio e cada correção manual.
- Registre os resultados. O relatório de testes abrange escopo, data, metas, valores medidos, falhas e riscos em aberto.
- Preencha as lacunas. Corrija o manual de procedimentos, a configuração, as credenciais ou as licenças e atribua um responsável e uma data de vencimento para cada constatação.
- Repetir o teste. Repita o que falhou, atualize o plano e agende o próximo teste.
O que medir: RTO, RPO e outros resultados de testes.
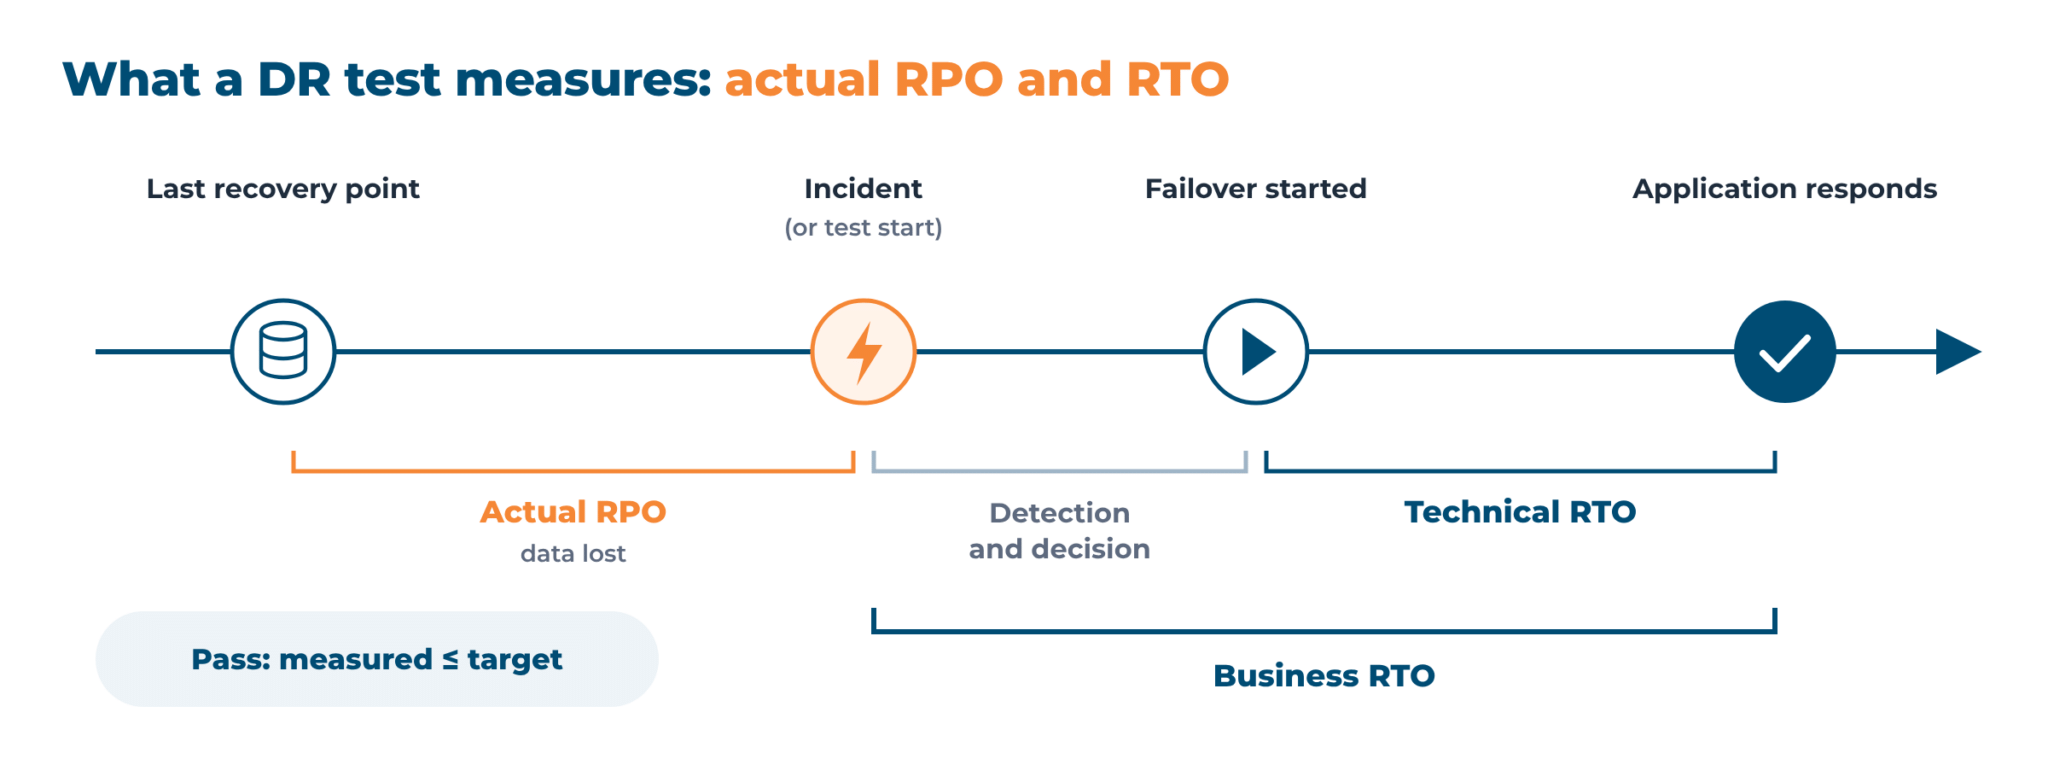
RTO e RPO, os objetivos de recuperação, são apenas metas até que um teste as meça. Diferença entre RTO e RPO Este artigo tem seu próprio conteúdo, portanto, esta seção aborda a medição. Seis métricas são suficientes.
| Métrica | Como isso é medido no teste | Critério de aprovação | Falha típica |
|---|---|---|---|
| RTO real | Tempo decorrido desde o comando de failover até que a aplicação responda a uma solicitação de teste (RTO técnico); o RTO de negócios também inclui o tempo de detecção e decisão. | O RTO técnico, somado ao tempo de detecção e decisão, está igual ou abaixo do RTO de negócios. | Restauração lenta do disco, ordem de inicialização incorreta, etapas manuais |
| RPO real | Idade dos dados mais recentes no sistema recuperado, em comparação com o momento em que o teste de failover foi iniciado. | Em ou abaixo do RPO alvo. | Atraso na replicação, agendamento ignorado, ponto de recuperação mais antigo do que o previsto. |
| Verificação de integridade de dados | Somas de verificação, contagens de linhas ou consultas comparadas com a fonte | Não há registros corrompidos ou faltantes. | Cópia consistente em caso de falha de um banco de dados ocupado; snapshots consistentes com o aplicativo evitam isso. |
| Verificação de integridade do aplicativo | Login, uma transação chave e uma chamada de API, de ponta a ponta. | Todas as transações críticas são aprovadas. | A máquina inicia, mas o aplicativo não consegue acessar o DNS, o banco de dados ou o servidor de licenças. |
| Tempo de retorno | Hora de retornar as cargas de trabalho e os dados alterados para produção. | Dentro do período de manutenção planejado | O mecanismo de failback nunca foi testado, devido ao grande volume de alterações. |
| Intervenções manuais | Número de etapas executadas fora do manual de procedimentos ou da automação. | Cada etapa documentada | Soluções conhecidas apenas por um engenheiro |
Métricas para um teste de recuperação de desastres (DR), com critérios de aprovação e falhas típicas.
Failover versus failback: teste ambas as direções
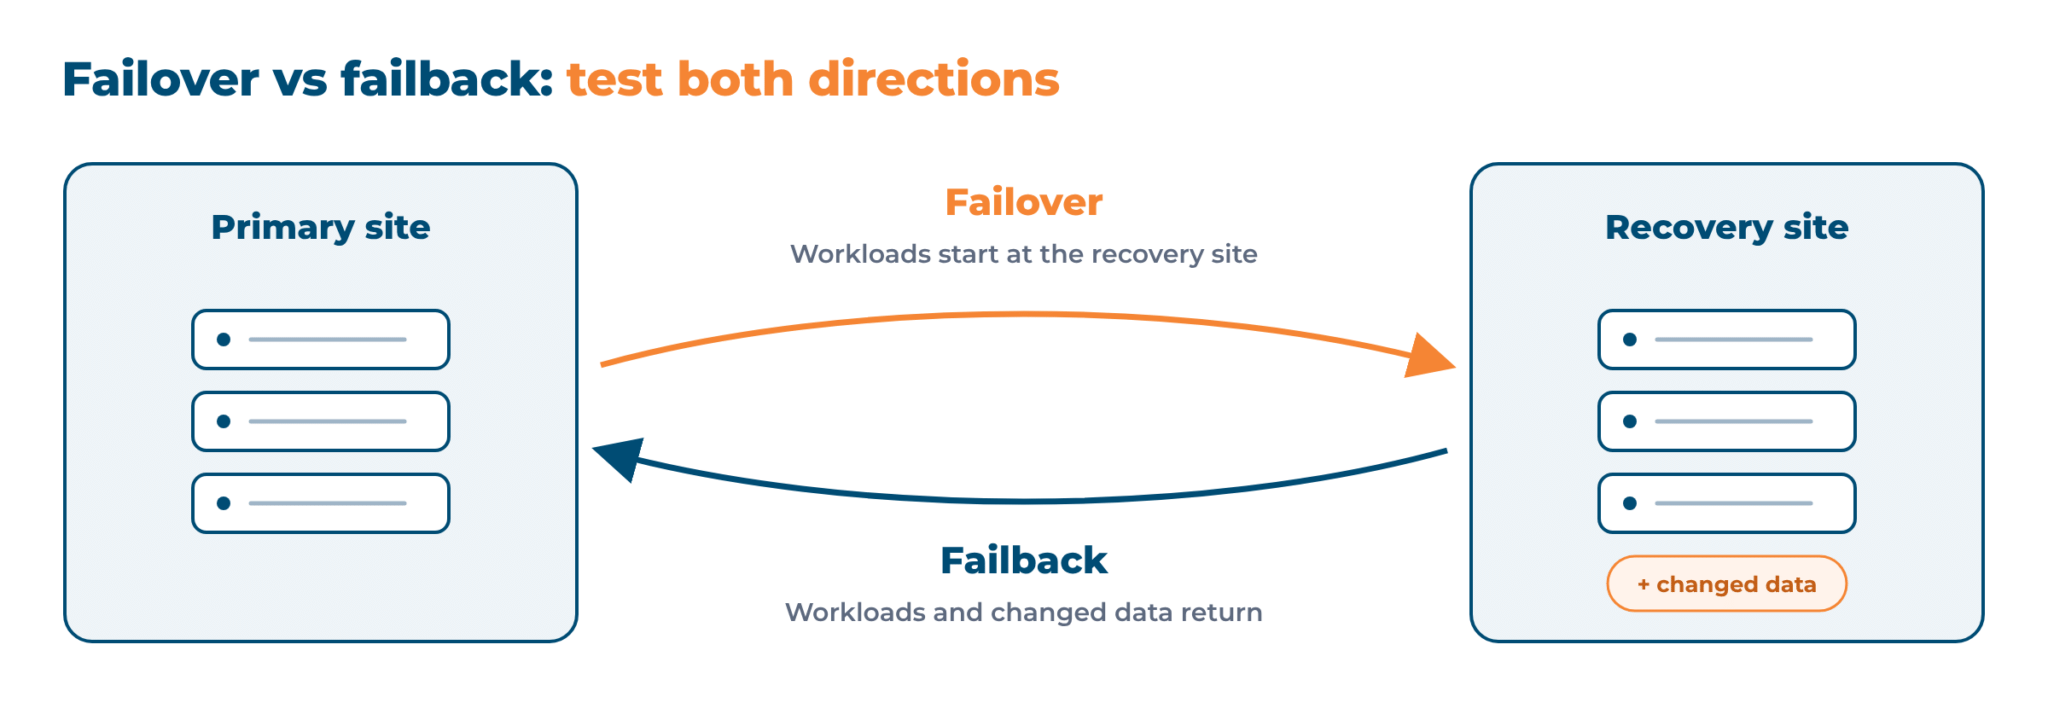
O failover transfere as cargas de trabalho para o site de recuperação, e o failback as retorna assim que o site primário for reparado, com os dados alterados nesse ínterim. Os testes de failover são rotineiros, mas o failback é fácil de ser negligenciado, portanto, o primeiro failback real não é testado. O teste anual de interrupção completa é o momento ideal para incluí-lo e cronometrá-lo. Quando a produção não pode ser desligada, a alternativa mais próxima é um teste de failover e failback de toda a pilha em um ambiente isolado.
Por que os testes de recuperação de desastres falham?
A recuperação muitas vezes não atinge seus objetivos. Pesquisa da Veeam sobre Tendências de Proteção de Dados de 2024 De 1.200 líderes de TI entrevistados, apenas 58% dos servidores atenderam ao SLA de recuperação no último ataque em larga escala. Sete causas são comuns.
- O local de recuperação difere do local de produção. As mudanças chegam à produção, mas não ao local de recuperação.
- As dependências permanecem não verificadas. Presume-se que o DNS, os serviços de diretório, os servidores de licença e as APIs de terceiros estejam funcionando corretamente.
- Não existe rede isolada. As equipes temem colisões com sistemas em funcionamento e continuam adiando o teste, embora um ambiente de testes reduza o risco.
- Credenciais e licenças expiram. Contas de serviço, certificados e chaves de licença expiram entre os testes.
- O manual de procedimentos pertencia a alguém que já saiu da empresa. Ninguém mais conhece os passos não escritos.
- Os critérios de sucesso nunca foram definidos. Um servidor que inicializa conta como aprovado.
- Apenas a infraestrutura é testada. A máquina virtual inicia, mas ninguém verifica se o aplicativo funciona.
Reverter essas causas constitui a essência das melhores práticas de teste para recuperação de desastres.
Automatizando e orquestrando testes de recuperação de desastres
Os testes manuais funcionam bem para poucas máquinas. Com mais máquinas, o manual de procedimentos fica extenso e as pessoas o executam de forma lenta e diferente a cada vez. A automação da recuperação de desastres transfere etapas individuais para o software: replicação de dados, inicialização de máquinas e verificação do resultado.
A orquestração de recuperação de desastres coordena essas etapas em uma sequência de recuperação: quais máquinas iniciam primeiro e quais esperam, a qual rede cada uma se conecta e qual verificação de integridade conclui uma etapa.
A mesma sequência posteriormente aciona o failover real. Na pesquisa de Tendências de Proteção de Dados de 2024 da Veeam, apenas 13% das organizações usavam fluxos de trabalho orquestrados em seus processos de recuperação de desastres.
A automação também torna viável o failover de teste sem interrupções. A replicação mantém uma cópia de cada máquina protegida no site de recuperação. No momento do teste, a ferramenta cria máquinas a partir de um ponto de recuperação ou snapshot escolhido dentro de uma rede de teste isolada. A produção continua em execução e as máquinas de teste são excluídas quando as verificações são concluídas.
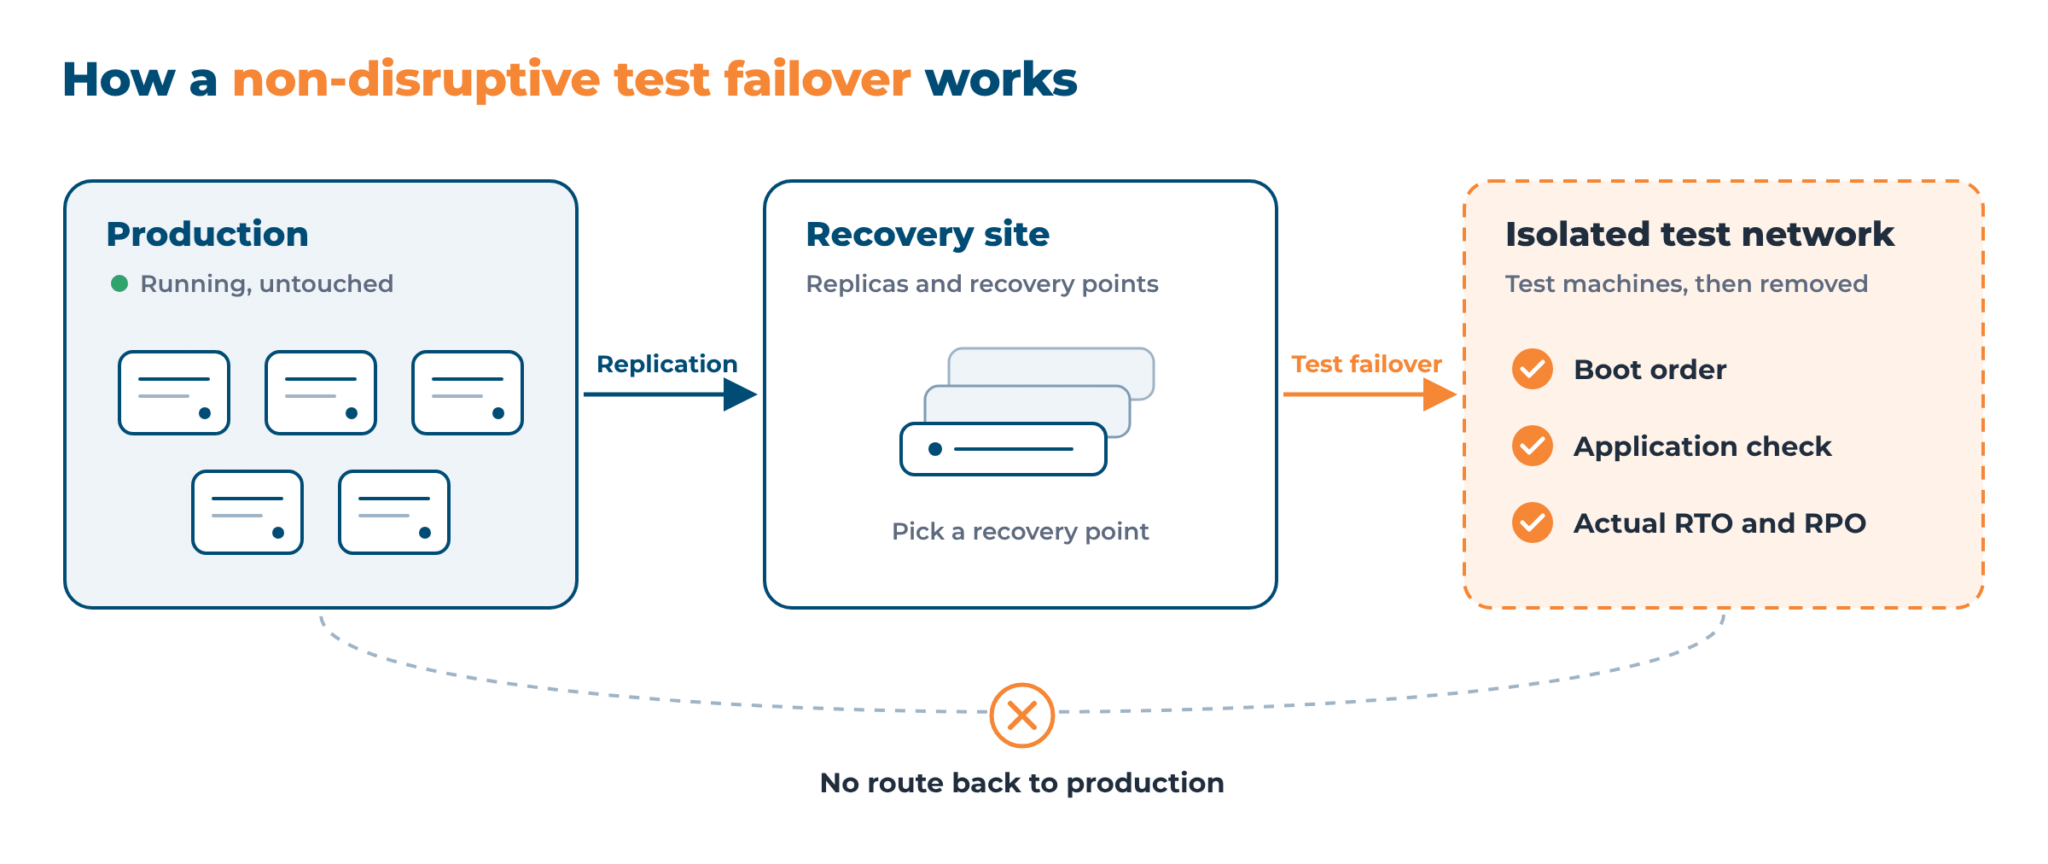
Em ferramentas que suportam testes agendados, um failover de teste pode ser executado automaticamente a cada trimestre, e cada execução gera um relatório com os tempos, o RTO medido e as etapas com falha para revisão dos auditores.
Testes de failover em nuvens privadas e plataformas de virtualização
Recuperação de desastres Hystax, parte da plataforma Hystax, suporta dois modos de replicação:
- A replicação sem agente funciona no nível da plataforma por meio de um agente Hystax externo, sem necessidade de instalação no sistema operacional convidado. Está disponível para VMware, OpenStack e oVirt.
- A replicação baseada em agente utiliza um agente Windows ou Linux dentro do sistema operacional convidado e abrange outros hipervisores, máquinas virtuais em nuvens públicas e servidores físicos.
Os planos de recuperação de desastres (DR) são gerados a partir da infraestrutura replicada, e o teste automático pode ser configurado dentro do plano.
Sobre Virtualização Red Hat OpenShift, Por exemplo, as equipes podem validar planos em um ambiente isolado a qualquer momento, sem afetar as cargas de trabalho de produção. Para o cenário de ransomware da etapa 1 do plano de teste, o recurso integrado proteção contra ransomware Indica um volume anormal de dados alterados durante a replicação.
A plataforma então coloca a máquina em estado de suspensão: ela para de criar novos pontos de restauração e não aplica a política de retenção, de modo que os pontos de restauração anteriores, após a restauração, permaneçam disponíveis.
Os alvos de recuperação incluem OpenStack, VMware, KVM, Red Hat OpenShift Virtualization, Virtuozzo, oVirt, OpenNebula e KubeVirt, além de AWS, Azure, Google Cloud (GCP) e Alibaba Cloud. O failback para o site primário está integrado. A recuperação também pode ser executada. através das nuvens.
A Adam Data Center, provedora independente espanhola de IaaS com data centers em Madri e Barcelona, adicionou recuperação de desastres ao seu portfólio de serviços. Nuvem baseada em OpenStack com Hystax. De acordo com o Estudo de caso de março de 2026, Os sistemas de destino podem ser inicializados individualmente ou em grupos, respeitando as dependências, e ambientes de contingência podem ser implantados e validados sem interromper a produção.
Fale com os engenheiros da Hystax sobre como testar os planos de recuperação na sua infraestrutura de TI.
Obrigado pelo seu pedido!
Entraremos em contato em breve.
Perguntas frequentes
O que é um teste de recuperação de desastres?
O teste de recuperação de desastres consiste em exercitar um plano de recuperação de desastres para verificar se a recuperação está de acordo com o RTO (Objetivo de Tempo de Recuperação) e o RPO (Objetivo de Ponto de Recuperação) declarados. O teste pode ser uma discussão em equipe ou uma simulação real de failover. Ele identifica dependências desatualizadas, credenciais expiradas e etapas ausentes antes que uma interrupção real ocorra.
Quais são os tipos de testes de DR?
Existem seis tipos comuns: revisão de planejamento, exercício teórico, teste de simulação, teste paralelo, teste de interrupção total e teste de failover sem interrupção. O escopo varia desde a discussão até uma paralisação completa da produção. A maioria das equipes combina vários tipos, realizando testes mais seguros com frequência e testes mais complexos anualmente.
Com que frequência um plano de recuperação de desastres deve ser testado?
A regra geral é um teste por ano por sistema crítico, mais um após alterações importantes, como uma migração de plataforma. As cargas de trabalho críticas podem ser testadas trimestralmente com um failover de teste, pois, com uma rede de teste isolada, isso não afeta a produção. A DORA exige testes anuais para entidades financeiras da UE.
O que é um failover de teste não disruptivo?
Um failover de teste não disruptivo recupera cargas de trabalho de dados replicados para uma rede de teste isolada, enquanto a produção continua em funcionamento. Os usuários de produção não são afetados. As máquinas de teste são removidas posteriormente, permitindo que as equipes meçam o tempo real de recuperação e verifiquem os aplicativos com a frequência necessária.
Quem é o responsável pelos testes de DR?
O responsável pela TI ou pela infraestrutura lidera o teste, os proprietários do sistema executam seus procedimentos de recuperação e um representante da empresa aprova o resultado. A gerência é responsável pelas metas de recuperação. DRaaS, O fornecedor se encarrega de grande parte dos testes, mas o cliente ainda valida as aplicações e aprova os resultados.
Qual a diferença entre failover e failback?
O failover transfere as cargas de trabalho do site primário para o site de recuperação, seja em uma interrupção real ou durante um teste. O failback as retorna assim que o site primário for reparado, juntamente com os dados alterados nesse ínterim. Ambos os processos precisam ser testados, pois somente um failback testado demonstra se os dados alterados retornam intactos.
O que deve conter um relatório de teste de DR?
Um relatório de teste de recuperação de desastres (DR) registra o escopo, a data e o tipo de teste, os objetivos de tempo de recuperação (RTO) e os objetivos de ponto de recuperação (RPO) alvo e medidos, os resultados da verificação de dados e aplicativos, o tempo de failback, as intervenções manuais, as etapas com falha e os riscos em aberto. Cada constatação recebe um responsável e uma data de vencimento. O relatório também serve como evidência para auditoria.
Um plano de recuperação só é tão bom quanto seu último teste bem-sucedido. Simulações e falhas reais expõem lacunas e dependências ausentes, portanto, o plano é revisado após cada teste e alteração importante.
Para informações sobre tipos de testes, frequência e um plano passo a passo, consulte nosso guia sobre Como testar um plano de recuperação de desastres.